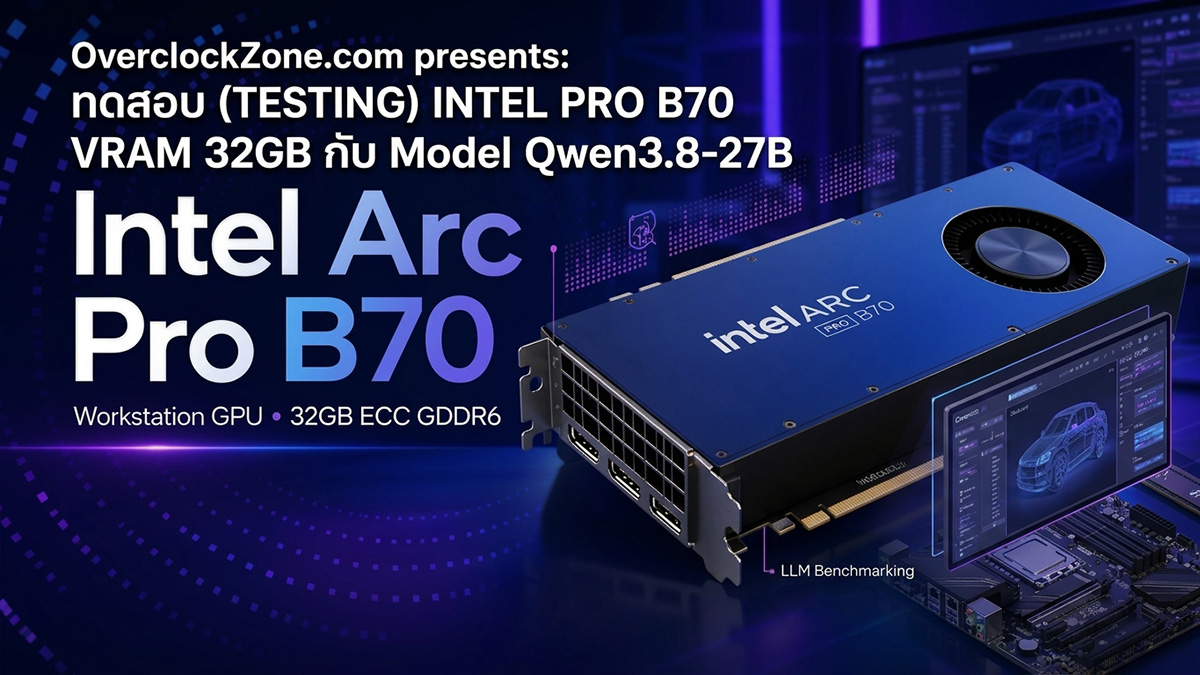
วันนี้เราก็ได้การ์ดจอ INTEL ARC PRO B70 มาซึ่งมี VRAM มา 32GB ซึ่งเพียงพอต่อการรัน Model ยอดนิยมอย่าง Qwen 3.8 27B แบบ 4 bit ได้อย่างสบายๆพร้อมทำ Cache ได้อีก ในบทความนี้เราจะมาทดสอบกันว่า INTEL Arc Pro B70 นั้น จะสามารถทำประสิทธิภาพได้เท่าไหร่
อย่างที่ทุกคนทราบกันว่า ช่วงนี้กระแส Local Ai นั้นมาแรงมากๆจนทำให้การ์ดจอที่มี VRAM สูงๆนั้นราคาพุ่งสูงขึ้นทั้งหมด รวมถึงอุปกรณ์ต่างๆของคอมพิวเตอร์ก็มีการปรับราคาขึ้นตามไปด้วย และ การรัน AI นั้นมีความจำเป็นมากที่ต้องการใช้ VRAM และการ์ด b70 ใบนี้ก็มี vRAM ที่เยอะอยู่พอสมควรเลยในตลาดที่ ราคายังไม่แพงมาก หลายๆคนอาจจะมองๆและเล็งๆการ์ดใบนี้อยู่หลายคน เพื่อที่จะมาใช้งาน Local Ai กันวันนี้ผมก็จะมาทดสอบให้ดูกัน และพยายามเขียนบทความนี้ให้กระชับที่สุด โดยผมจะมุ่งเน้นไปในการใช้งานคนเดียวเป็นหลัก และ การใช้งานหลายๆคนเป็นรอง
เริ่มจาก SPEC เครื่องที่ผมใช้ในการทดสอบก่อน
Motherboard - ASUS Z170-WS
CPU - Core i7-7700K
RAM 16 GB
OS - Ubuntu 24.04
PCIe 3.0 x16 - INTEL ARC PRO B70
** แน่นอนครับว่า INTEL Arc Pro B70 นี้จะวิ่งบน PCIe 5 แต่ตอนนี้เครื่องผมเป็น PCIe 3.0 มีผลกับเวลาโหลดโมเดลเป็นหลัก กระทบความเร็ว token น้อย **
1. สรุปก่อนอ่านให้คร่าวๆก่อนเลยครับ
|
57.7 tok/sใช้คนเดียว งานจริง · MTP3 |
225 tok/sรวมทั้งการ์ด เมื่อ 10 คนใช้พร้อมกัน |
261,168 โทเคนprompt ยาวสุดที่รันผ่าน (99.6% ของสเปกโมเดล) |
สามารถตั้ง Power Limit 190 W ลดจาก 230 W ได้ถ้าใช้งานเพียงคนเดียว มีผลกระทบน้อยมาก |
จุดแข็ง
|
จุดอ่อน
|
-
32 GB บนการ์ดเดียว รันโมเดล 27B พร้อม context เต็มได้จริง ซึ่งการ์ด 24 GB ทำไม่ได้
-
vLLM ทำงานจริง พร้อม continuous batching ยิ่งคนใช้เยอะ throughput รวมยิ่งเพิ่ม
-
ความร้อนตอนโหลดเต็ม ชิป 76°C
-
รับภาพ (vision) และ tool calling ได้ครบ
|
-
ติดตั้งยาก — อาจจะเสียเวลาไปหลายชั่วโมงมากๆเพื่อให้ได้ประสิทธิภาพสูงที่สุด
-
ปัญหามีหลายอย่างเช่น Driver ของ Intel เองใช้ไม่ได้ — xpu-smi และ intel_gpu_top ไม่รู้จักไดรเวอร์ xe
-
ซอฟต์แวร์ยังไม่นิ่ง — เปิด MTP แล้ว prefix caching ใช้กับบทสนทนาต่อเนื่องไม่ได้ ต้องเปลี่ยนไปใช้ vLLM รุ่นใหม่กว่าพร้อม patch ของ Community ถึงจะได้ทั้งคู่
-
fork ของ Intel (llm-scaler) ตามหลังต้นทาง 7 เวอร์ชัน และช้าลงหนักเมื่อ context ยาว
|
2. วิธีวัด
แน่นอนครับว่าการทดสอบนี้กินเวลาไป หลายวันมากๆ ผมจึงใช้ Ai agent ในการเข้าช่วยในการรันคำสั่งถัดไปเมื่อการ Benchmark เสร็จในแต่ละขั้นตอนเสร็จ ฮ่าๆๆ
|
หัวข้อ |
ค่าที่ใช้ |
|
โมเดลหลัก |
Qwen3.8-27B quantize 4 บิต (AWQ / compressed-tensors) ขนาด 19.5 GB มี MTP |
|
“N คน” |
ยิงคำขอ N ชุดพร้อมกันเป๊ะ แล้วจับเวลาจนครบทุกชุด — หนักกว่าการใช้จริงที่คนพิมพ์ไม่พร้อมกัน |
|
ทำซ้ำ |
3 รอบต่อจุด เลือกรอบที่ดีที่สุด · warm-up ก่อนจับเวลา · เก็บ %CPU คู่กันทุกจุด |
|
ความแปรปรวน |
ระหว่างรอบราว 3% — ความต่างที่น้อยกว่านี้ไม่นับเป็นผลจริง |
|
CPU |
vLLM ใช้ราว 14–20% ระหว่างวัด — ไม่ใช่คอขวด |
3. ความเร็วของแต่ละ Engine รันแบบเดิมๆยังไม่ปรับแต่ง
กราฟนี้สรุปได้ว่า
ใช้คนเดียว vLLM เร็วที่สุด เร็วกว่า fork ของ Intel 18%
หลายคนพร้อมกัน llm-scaler แซง ที่ 8 คนเร็วกว่า 1.38 เท่า
Ollama throughput รวมตรึงที่ ~11 tok/s ไม่ว่ากี่คน เพราะไม่มี continuous batching คนที่ 2 ขึ้นไปต้องรอคิว
Ollama กิน CPU 37% เทียบกับ vLLM 14–20% — backend Vulkan โยนงานให้ CPU มากกว่า
และแน่นอนครับว่า เมื่อผมเห็นความเร็วแบบนี้ ผมเลยจะพุ่งเป้าไปใช้งานเพียงแค่ vLLM , LLM-Scaler 2 ตัวนี้เท่านั้น และค่อยมาปรับแต่ง ตั้งค่าเพื่อให้ได้ประสิทธิภาพที่ดีที่สุด
4. ทดลองการใช้งาน MTP
MTP (Multi-Token Prediction) ให้โมเดลเดาคำถัดไปล่วงหน้าหลายตัวแล้วตรวจทีเดียว ถ้าเดาถูกได้หลายโทเคนในหนึ่งรอบ Qwen3.8 มี MTP ในไฟล์โมเดลอยู่แล้ว เปิดด้วยคำสั่ง --speculative-config


MTP กับงานจริง และ context ที่ยาวขึ้น
1 คน - ผ่าน chat template - โหมดคิดระดับ medium - sampling ตามที่ Qwen แนะนำ - ตอบสูงสุด 1,024 โทเคน - ไม่รวมเวลาอ่าน prompt
ผมได้เลือกใช้โจทย์หลายๆแบบ ทั้งเขียน Code , เขียนบทความ , คุยสอบถามทั่วไป
สรุปเรื่อง MTP
MTP เร็วขึ้นราวเท่าตัวในงานจริง และข้อได้เปรียบไม่หายไปเมื่อบทสนทนายาวขึ้น - ทุกระดับช้าลงในสัดส่วนใกล้เคียงกัน (9-19% จากโจทย์สั้นถึง 64k)
MTP3 คุ้มที่สุด เร็วกว่า MTP2 ราว 3-9% ส่วน MTP4 ชนะบางช่วงแต่แพ้ที่โจทย์สั้นและที่ 64k แถมกิน KV cache มากกว่า
เวลาอ่าน prompt เท่ากันทุกระดับ MTP - MTP ไม่ได้ทำให้ช่วงอ่าน context ช้าลง
แน่นอนครับ ว่า FP16 นั้นอาจจะเหลือ KV Cache ไม่พอใช้งานบนการ์ดไปนี้ ซึ่งผมก็ต้อง เปลี่ยนไปใช้ FP8 แทน
5. ปัญหา MTP กับ prefix caching - ที่หลายๆคนตาม Community พบเจอกัน ตอนนี้สามารถแก้ไขได้แล้ว
prefix caching คือการจำ context ที่อ่านไปแล้ว เมื่อคุยต่อจากบทสนทนาเดิม engine ไม่ต้องอ่านใหม่ทั้งหมด และ นี่คือปัญหาหลักที่หลายๆคนไม่สามารถเปิดการใช้งานได้ในการ์ดใบนี้ แต่ตอนนี้มี Patch แก้ไขแล้ว
นี่เป็นบั๊กของ vLLM ไม่ใช่ข้อจำกัดของตัวโมเดล (vllm#54360 · PR #52244, #55390) ผมจึงสร้าง image ใหม่จาก vLLM 0.29.0 แล้วใส่ patch แก้ไขให้ถูกต้อง 5 ตัวจาก B70 cookbook ที่อยู่ใน Community)
อย่างที่เห็นในภาพเลยครับ เมื่อเราได้ทำการ Patch แล้วประสิทธิภาพดีขึ้นอย่างชัดเจนเลย
6. ทดลองใช้ KV CACHE แต่ละแบบดู
แน่นอนครับ KV Cache นั้นคือส่วนสำคัญในการใช้งานเมื่อเราคุยต่อไปเรื่อยๆ ผลทดสอบออกมาดังนี้
สำหรับผมแล้วจุดที่ผมว่าคุ้มค่าและดีที่สุด คือ FP8
*** Turboquant 4bit ที่ผมโหลดไม่สามารถทดสอบได้อย่างสมบูรณ์ อาจเกิดจาก Ram ตัวเครื่องผมที่มีขนาด 16GB ไม่เพียงพอต่อการใช้งาน เลยไม่สามารถทดสอบได้ครบครับ ***
7. ทดลอง Context แบบยาวๆ
จำลองการใช้งานแบบการเขียน coding เปิดการใช้งาน MTP3 + prefix cache FP8
ในรูปดังที่เห็นกันเลย การเปิด prefix caching คุยต่อที่ 128k รอ 11.1 วินาทีแทน 187 วินาที (เร็วขึ้น 17 เท่าถ้าไม่เปิด prefix cache) และที่ 64k รอ 4.9 วินาทีแทน 64.7 (เร็วกว่า13 เท่า)
8. throughput รวมทั้งการ์ด
เมื่อปรับแต่ง Patch เรียบร้อยแล้ว ผมก็มาทดสอบโดยการจำลองการใช้งานพร้อมๆกันหลายๆคน เพื่อเป็นการทดสอบ throughput ของการ์ด Intel Arc pro B70 นี้ที่สามารถทำได้มากที่สุดผลออกมาดังนี้
ก็จบลงไปแล้วนะครับ สำหรับผลการทดสอบ INTEL ARC PRO B70 ในครั้งนี้ และนี่อาจจะไม่ใช่ผลทดสอบที่ดีที่สุดเนื่องจากอย่างที่ทุกคนทราบกันอยู่แล้วว่า แม้กระทั้งตัว Driver เอง หรือ Engine ต่างๆ อาจจะยังไม่รองรับแบบสมบูรณ์ 100% ปัญหาต่างๆมีค่อนข้างมากมายและต้องแก้ไขปัญหาเองเยอะอยู่
สรุปเลยหลังจากที่ผมปลุกปล้ำกับการ์ดใบนี้มาหลายวัน หลายคืน ในมุมมองของผม ผมมองว่าการตั้งค่าที่ดีที่สุด ณ. ตอนนี้ กับ Driver และ Patch ที่มีตอนนี้ คือ
|
คอนฟิก |
context |
KV cache |
ผล |
|
vLLM 0.29 + patch · fp8 · util 0.97 · MTP3 + prefix cache |
192,512 |
195,343 |
ใช้งานได้จริง |
แต่แน่นอนครับว่าเราอาจจะเสีย Context ลงมาจาก 262,144 ไปพอสมควร แต่จุดนี้เป็นจุดที่ใช้งานได้ดีและลื่นไหลมากที่สุด ใน Driver , Patch ปัจจุบันนี้ สวัสดีครับ
แน่นอนครับว่าการ์ด INTEL ARC Pro B70 นี้อาจจะยังไม่เหมาะสำหรับผู้ที่ต้องการซื้อไปแล้วใช้งานได้ทันทีเหมือนกับการ์ดจอฝั่งค่ายสีเขียว หรือ สีแดง แต่ถ้าเพื่อนๆพอจะมีเวลาปลุกปล้ำกับการ์ดใบ เพื่อเป็นทางเลือกในการประหยัดเงิน ผมก็มองว่าการ์ดใบนี้น่าสนใจไม่น้อยเลยครับ
สำหรับใครที่ซื้อการ์ดใบนี้ไป และ จะกังวลว่าจะไม่สามารถตั้งค่าใช้งานการ์ดใบนี้ได้ ผมจะบอกว่าไม่ต้องกังวลเลยครับ ปัจจุบันนี้ผมเชื่อว่าทุกๆคนน่าจะซื้อบริการ Ai จากผู้ให้บริการกันอยู่แล้ว เช่น Claude , OpenAi ที่มีโมเดลเก่งๆ เราสามารถใช้ Ai เหล่านี้ช่วยในการติดตั้งให้ใช้งานได้อย่างง่ายได้ จนไม่มีอะไรต้องกังวลเลยครับ สำหรับใครที่ต้องการ Patch แบบผมก็แค่ให้ Ai ของคุณนั้นเข้ามาอ่านบทความนี้ ง่ายๆเลยครับ