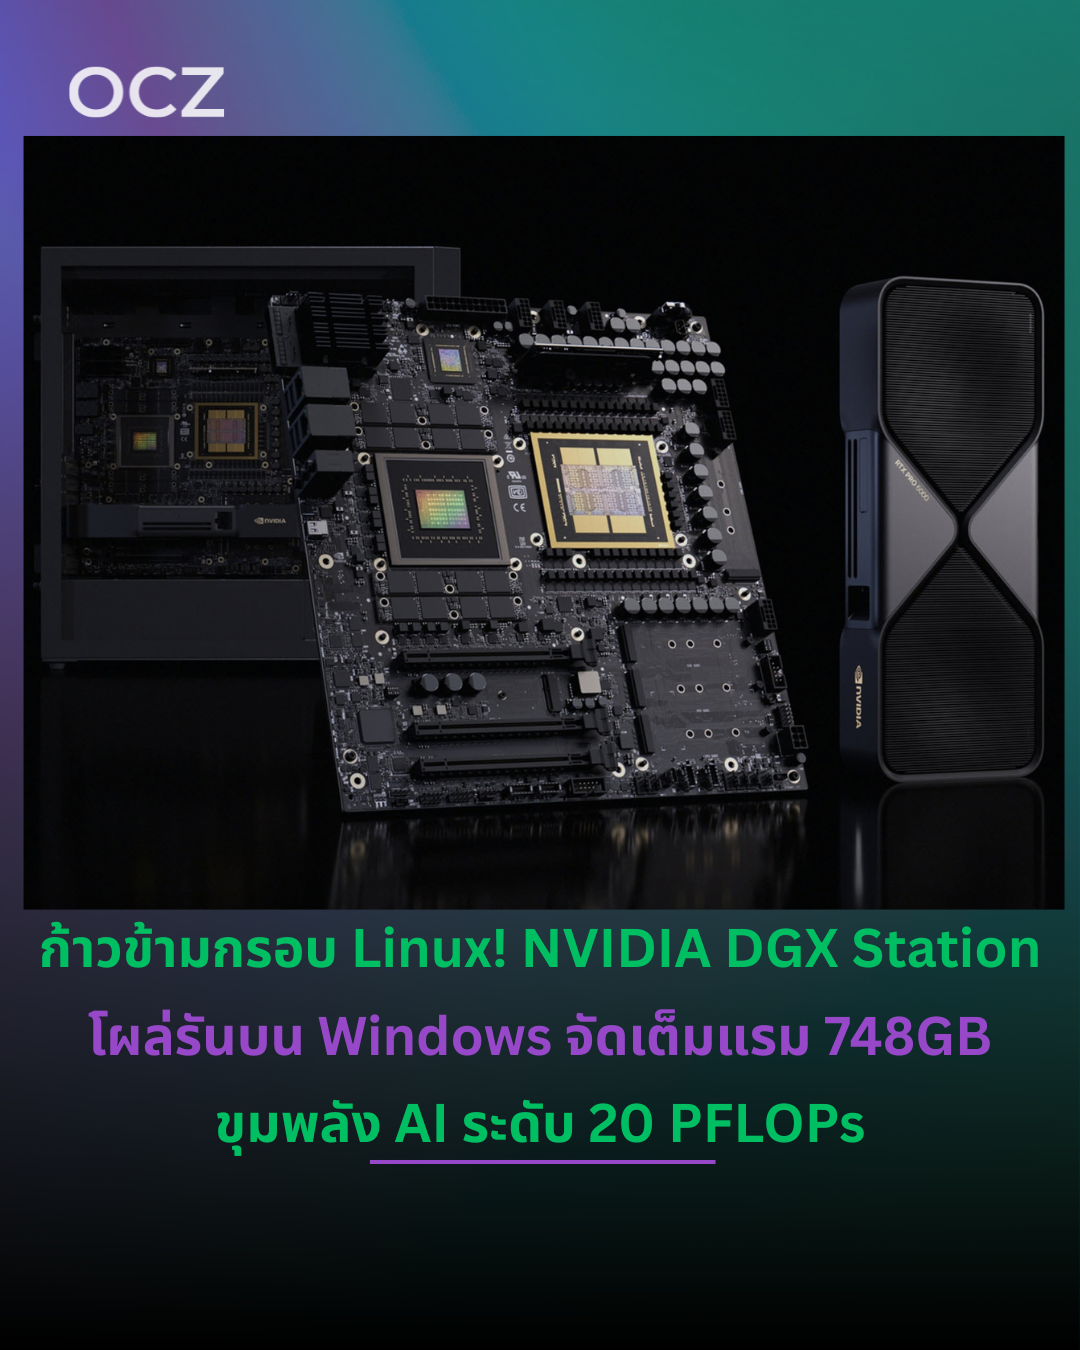
NVIDIA เปิดตัว DGX Station สำหรับ Windows ใช้ GB300 Blackwell Ultra แรง 20 PFLOPs RAM รวม 748GB
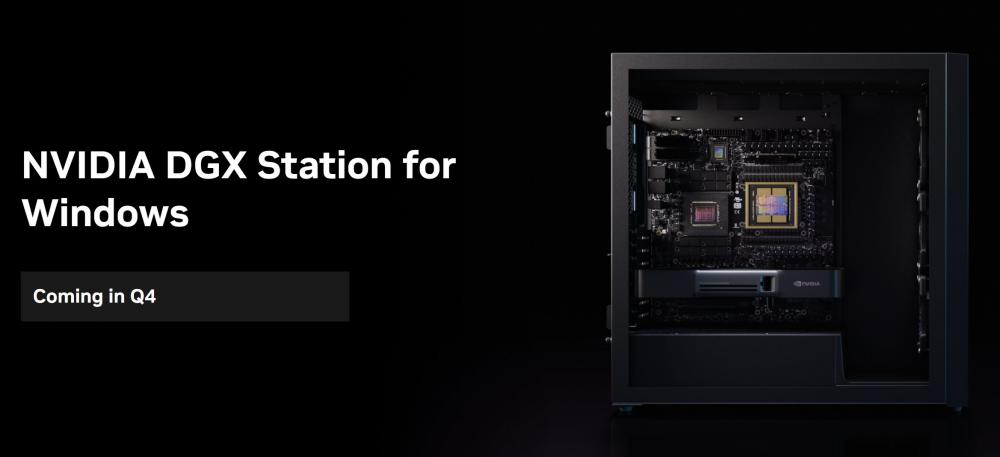
NVIDIA เดินหน้าขยายตลาด Local AI จากเครื่อง AI ขนาดเล็กไปสู่ระดับ Workstation อย่างจริงจัง ล่าสุดประกาศนำ DGX Station มารองรับ Windows เป็นครั้งแรก หลังจากก่อนหน้านี้ระบบดังกล่าวทำงานบน Linux เป็นหลัก โดยรุ่นใหม่จะใช้ชิป NVIDIA GB300 Blackwell Ultra และให้พลังประมวลผล AI สูงสุดระดับ 20 PFLOPs
การเพิ่ม Windows เข้ามาถือเป็นการปิดช่องว่างสำคัญสำหรับองค์กรที่ใช้งาน Windows เป็นระบบหลัก เพราะในอดีตนักพัฒนาต้องแยกสภาพแวดล้อมระหว่าง Linux สำหรับงาน AI หนัก ๆ กับ Windows สำหรับซอฟต์แวร์ด้าน Productivity และ Workflow อื่น ๆ
NVIDIA ระบุว่าการรองรับ Windows จะช่วยให้นักพัฒนาสามารถทำงานด้าน AI บนเครื่องเดียวได้ง่ายขึ้น โดยไม่ต้องสลับระบบปฏิบัติการเพื่อเข้าถึงขีดความสามารถด้าน AI Compute ระดับสูง
GB300 Blackwell Ultra ให้ 20 PFLOPs
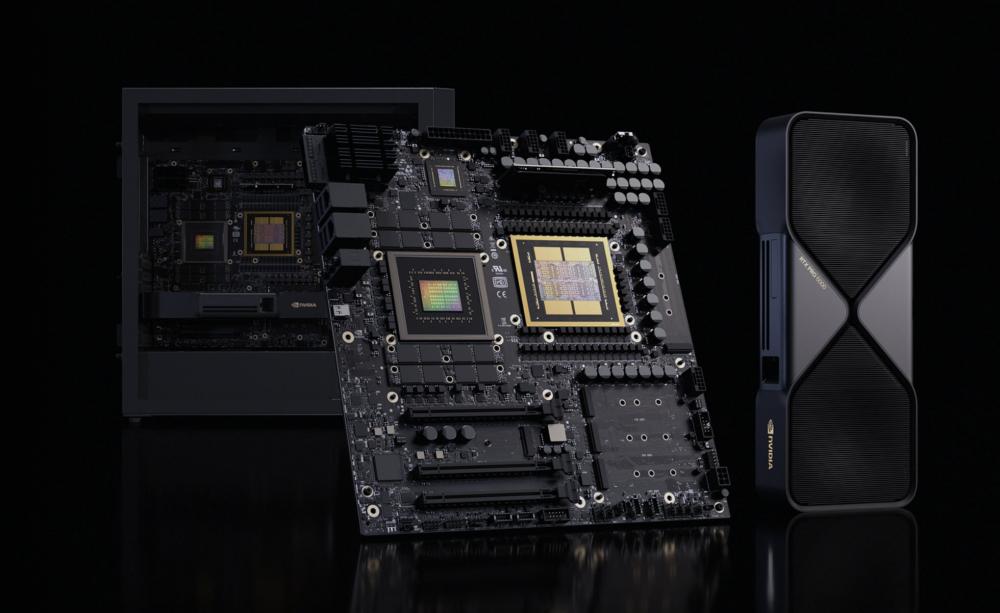
หัวใจหลักของ DGX Station รุ่นใหม่นี้คือ GB300 Blackwell Ultra ซึ่งใช้ GPU จำนวน 1 ตัวภายในระบบ
ชิปดังกล่าวประกอบด้วย 160 SMs แต่ละ SM มี 128 CUDA Cores ทำให้รวมเป็น 20,480 CUDA Cores พร้อม Tensor Cores รุ่นที่ 5 จำนวน 640 คอร์
Blackwell Ultra ยังมี Tensor Memory หรือ TMEM ขนาดรวม 40MB และรองรับการประมวลผล AI ในรูปแบบความแม่นยำใหม่อย่าง FP8, FP6 และ NVFP4
หนึ่งในจุดเด่นสำคัญคือการเพิ่มประสิทธิภาพด้านหน่วยความจำ โดย GB300 มาพร้อม HBM3e ขนาด 252GB และแบนด์วิดท์สูงถึง 7.1TB/s ซึ่งมากกว่าความจุสูงสุด 192GB ของโซลูชัน Blackwell GB200 รุ่นก่อนหน้า
NVIDIA ระบุว่า NVFP4 สามารถเพิ่มประสิทธิภาพ Dense Low-Precision Compute ได้สูงสุดประมาณ 50% และให้ความแม่นยำใกล้เคียง FP8 โดยความแตกต่างในหลายกรณีต่ำกว่า 1% ขณะเดียวกันยังช่วยลด Memory Footprint ลงประมาณ 1.8 เท่าเมื่อเทียบกับ FP8 และ 3.5 เท่าเมื่อเทียบกับ FP16
CPU Grace 72 คอร์ พร้อมหน่วยความจำ 496GB
ฝั่ง CPU ใช้ NVIDIA Grace จำนวน 1 ชิป ซึ่งมี 72 คอร์ บนสถาปัตยกรรม Neoverse V2
ระบบยังติดตั้ง LPDDR5X ขนาด 496GB เพิ่มเติมจาก HBM3e 252GB ทำให้มีหน่วยความจำรวมทั้งระบบประมาณ 748GB
LPDDR5X ฝั่งระบบมีแบนด์วิดท์ประมาณ 396GB/s ขณะที่ CPU และ GPU เชื่อมต่อกันผ่าน NVLink-C2C ความเร็ว 900GB/s
การออกแบบลักษณะนี้ทำให้ DGX Station สามารถจัดการโมเดล AI ขนาดใหญ่มากได้โดยไม่จำกัดอยู่กับ VRAM ของ GPU เพียงอย่างเดียว และเหมาะกับงานอย่าง Large Language Models, Mixture-of-Experts รวมถึงระบบ AI Agent ที่ต้องใช้หน่วยความจำมหาศาล
Networking 800Gbps พร้อม RTX PRO Blackwell
ด้านการเชื่อมต่อ NVIDIA ใส่ CX8 SuperNIC ที่รองรับความเร็วเครือข่ายสูงถึง 800Gb/s
ตัวเครื่องยังรองรับการ์ดจอ NVIDIA RTX PRO Blackwell เพิ่มเติม และมีสล็อต PCIe Gen5 x16 เต็มรูปแบบ รวมถึงสล็อต PCIe Gen5 x16 อีก 2 สล็อตที่ทำงานทางไฟฟ้าที่ x8
พื้นที่จัดเก็บข้อมูลประกอบด้วย M.2 Gen5 จำนวน 4 ช่อง ขณะที่พอร์ตเครือข่ายมี Ethernet รวม 4 พอร์ต แบ่งเป็น 2× 400GbE, 1× 10GbE และ 1× 1GbE
ทั้งหมดนี้อยู่ภายใต้ระบบที่มี TDP 1,600W ซึ่งสะท้อนอย่างชัดเจนว่า DGX Station ไม่ใช่พีซี Workstation ทั่วไป แต่เป็นเครื่อง AI สำหรับการประมวลผลระดับสูงโดยเฉพาะ
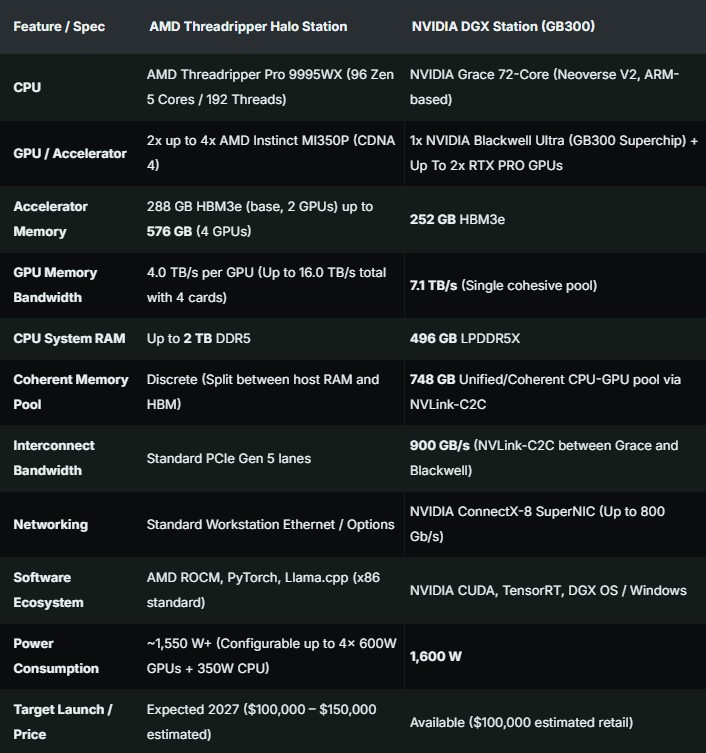
NVIDIA ชน AMD Threadripper Halo Station
การเปิดตัว DGX Station for Windows เกิดขึ้นไม่นานหลังจาก AMD เปิดตัว Threadripper Halo Station ซึ่งใช้ซีพียู Threadripper ร่วมกับ Radeon PRO และตั้งเป้าเป็น Workstation สำหรับ Local AI เช่นเดียวกัน
AMD คาดว่าจะเปิดตัว Halo Station ในปี 2027 ขณะที่ NVIDIA ระบุเพียงว่า DGX Station for Windows มีแผนวางจำหน่ายในไตรมาส 4 ปี 2026 โดยยังไม่มีวันที่วางจำหน่ายที่แน่นอน
ด้านราคา DGX Station อยู่ที่ประมาณ 100,000 ดอลลาร์สหรัฐ หรือราว 3.4 ล้านบาท ขึ้นอยู่กับอัตราแลกเปลี่ยนและการกำหนดค่าของระบบ
นั่นทำให้ทั้งสองแพลตฟอร์มกำลังมุ่งเข้าสู่ตลาดเดียวกัน นั่นคือเครื่องสำหรับองค์กร นักพัฒนา AI และผู้สร้างระบบ Local AI ที่ต้องการประสิทธิภาพระดับ Data Center แต่ต้องการให้ฮาร์ดแวร์อยู่ภายในสำนักงานหรือศูนย์ข้อมูลของตัวเอง
จาก AI Box สู่ AI Workstation
สิ่งที่น่าสนใจที่สุดคือทิศทางของตลาดกำลังเปลี่ยนจาก AI Mini PC ไปสู่เครื่อง Workstation ขนาดใหญ่ขึ้นอย่างรวดเร็ว
NVIDIA มีทั้ง DGX Spark สำหรับระบบขนาดเล็ก และตอนนี้กำลังขยับขึ้นมาสู่ DGX Station ที่มีพลังประมวลผลระดับ 20 PFLOPs พร้อมหน่วยความจำรวม 748GB ขณะที่ AMD ก็มี Ryzen AI และ Threadripper Halo Station เข้ามาแข่งขันในตลาดเดียวกัน
เหตุผลสำคัญมาจากความต้องการรัน AI แบบ Local ที่เพิ่มขึ้นอย่างต่อเนื่อง โดยเฉพาะโมเดลขนาดใหญ่, AI Agent และระบบองค์กรที่ต้องการลดการพึ่งพา Cloud รวมถึงต้องการควบคุมข้อมูลไว้ภายในระบบของตัวเอง
ดังนั้นการแข่งขันครั้งต่อไปอาจไม่ได้อยู่แค่ระหว่าง “การ์ดจอใครแรงกว่า” แต่อาจกลายเป็นการแข่งขันกันทั้งแพลตฟอร์ม ตั้งแต่ CPU, GPU, Unified Memory, Interconnect, Networking ไปจนถึง Software Ecosystem และในสนามนี้ NVIDIA กำลังพยายามขยาย CUDA และ TensorRT จากโลก Data Center ลงมาอยู่บนโต๊ะทำงานของนักพัฒนาโดยตรง
ที่มา: Wccftech