NVIDIA เปิดเกม Local AI เต็มสูบ! RTX Spark แรมรวม 128GB, DGX Spark ต่อคลัสเตอร์ 8 เครื่องได้ 1TB พร้อมเปิดตัว AI Coding รุ่นใหม่ Recursive Flint
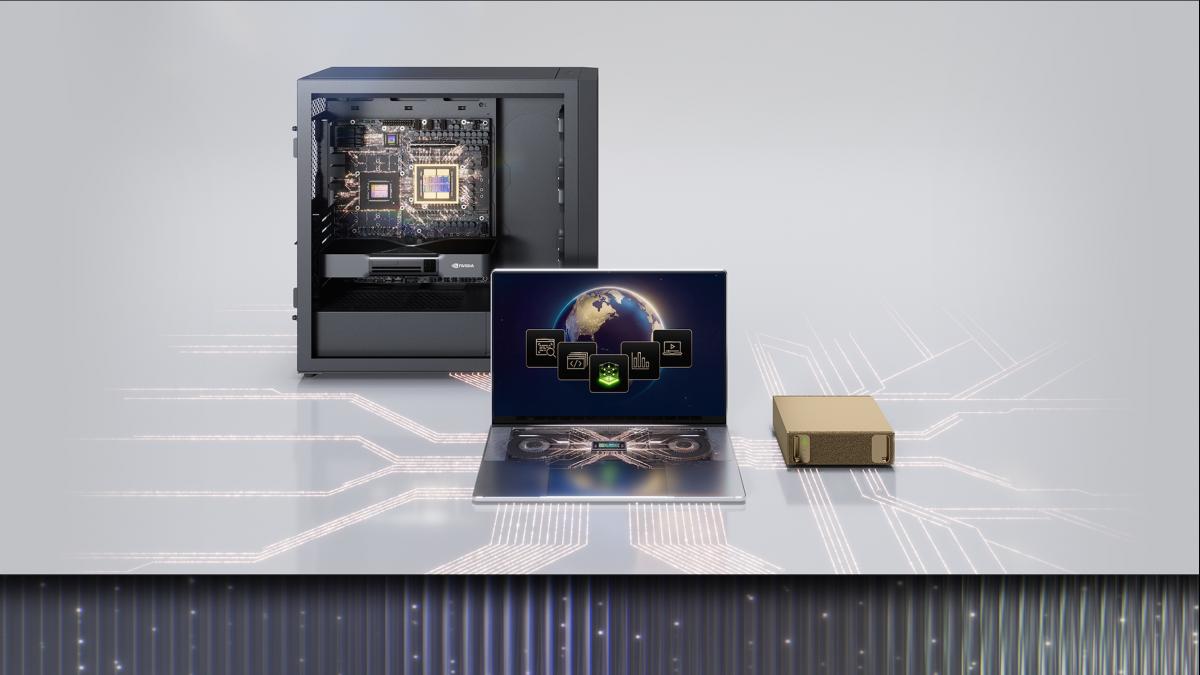
NVIDIA เดินหน้าผลักดันการประมวลผล AI บนเครื่องโดยตรง หรือ Local AI อย่างจริงจังในงาน GTC Berlin 2026 ด้วยการเปิดเผยความคืบหน้าของฮาร์ดแวร์ตั้งแต่ RTX Spark สำหรับผู้ใช้ Windows, DGX Spark สำหรับนักพัฒนาบน Linux ไปจนถึง DGX Station สำหรับองค์กรที่ต้องการประมวลผล AI ขนาดใหญ่ภายในระบบของตัวเอง โดยไม่ต้องพึ่งพาคลาวด์ทุกขั้นตอน
การประกาศครั้งนี้ครอบคลุมทั้งระบบรัน AI Agent โมเดล AI สำหรับเขียนโค้ด การเชื่อมต่อเครื่องหลายเครื่องเพื่อเพิ่มหน่วยความจำ การจัดการระบบระดับองค์กร ไปจนถึงการเร่งความเร็วโมเดลผ่าน llama.cpp และ vLLM
RTX Spark นำ AI Agent มาไว้บน Windows พร้อมหน่วยความจำรวมสูงสุด 128GB
RTX Spark — พีซีสำหรับงาน AI, ครีเอเตอร์ และนักพัฒนา
1 PFLOP
ประสิทธิภาพ AI สูงสุดแบบ FP4
128GB
หน่วยความจำ Unified Memory สูงสุด
1440p / 100 FPS
เป้าหมายการเล่นเกมที่ NVIDIA ระบุ
RTX Spark เป็นแพลตฟอร์มพีซีที่ผสาน CPU สถาปัตยกรรม NVIDIA Grace เข้ากับ GPU ตระกูล Blackwell RTX ในชิปเดียว โดยมีหน่วยความจำรวมสูงสุด 128GB และประสิทธิภาพ AI สูงสุด 1 เพตะฟลอปที่ความแม่นยำ FP4 ช่วยให้ผู้ใช้รันโมเดลภาษาและ AI Agent บนเครื่องได้โดยตรง
นอกจากงาน AI แล้ว NVIDIA ยังวางตำแหน่ง RTX Spark สำหรับงานสร้างสรรค์ เช่น การตัดต่อวิดีโอ การสร้างภาพและเนื้อหาด้วย AI รวมถึงการเล่นเกม โดยบริษัทระบุว่าสามารถรองรับเกมระดับ AAA ที่ความละเอียด 1440p พร้อมเฟรมเรตมากกว่า 100 FPS ในการใช้งานที่เหมาะสม ทั้งนี้ ผลลัพธ์จริงยังขึ้นอยู่กับเกมและการตั้งค่าที่ใช้
หนึ่งในแอปพลิเคชันใหม่ที่รองรับ RTX Spark คือ Underdog Desktop Agent ซึ่งใช้เอนจิน Husky สำหรับประมวลผลโมเดล AI บนอุปกรณ์โดยตรง ทำให้ AI Agent สามารถทำงานได้โดยไม่ต้องส่งข้อมูลของผู้ใช้ออกไปยังเซิร์ฟเวอร์ภายนอกตามแนวทางการทำงานของแอป
NVIDIA ยังสาธิตการใช้ AI Agent บน RTX Spark ร่วมกับ NVIDIA Isaac Lab, Hermes Agent และ Nemotron 3.5 Bolt 74B เพื่อฝึกหุ่นยนต์ Microduck ของ Hugging Face โดยแสดงให้เห็นว่าพีซี Local AI สามารถเป็นส่วนหนึ่งของกระบวนการพัฒนาหุ่นยนต์ได้ ไม่ใช่มีไว้เพียงตอบคำถามหรือเขียนข้อความเท่านั้น
DGX Spark 64GB เริ่มส่งมอบ 23 ตุลาคม ต่อคลัสเตอร์ได้สูงสุด 8 เครื่อง
DGX Spark — ระบบ AI สำหรับนักพัฒนาและทีมวิจัย
8 เครื่อง
จำนวนระบบสูงสุดต่อคลัสเตอร์ตามการตั้งค่าที่รองรับ
1TB
หน่วยความจำรวมของคลัสเตอร์ตามที่ NVIDIA ระบุ
NVIDIA เตรียมเริ่มส่งมอบ DGX Spark รุ่นหน่วยความจำ 64GB ผ่านพันธมิตรในวันศุกร์ที่ 23 ตุลาคม 2026 โดยระบบรุ่นนี้ออกแบบมาให้นักพัฒนาสามารถสร้างและทดสอบโมเดล AI บน Linux รวมถึงใช้งานโมเดลที่มีขนาดใหญ่ขึ้นตามข้อจำกัดของฮาร์ดแวร์และซอฟต์แวร์ที่รองรับ
สำหรับงานที่ต้องใช้ทรัพยากรมากกว่าเครื่องเดียว DGX Spark รองรับการเชื่อมต่อหลายระบบผ่านเครือข่าย NVIDIA ConnectX-7 ร่วมกับ NVIDIA Sync Cluster Assistant โดยสามารถตั้งค่าคลัสเตอร์ได้สูงสุด 8 เครื่อง และมีหน่วยความจำรวมสูงสุด 1TB ตามข้อมูลของ NVIDIA
การรวมทรัพยากรลักษณะนี้ช่วยให้ทีมพัฒนาสามารถทำงานกับโมเดลที่ใหญ่ขึ้น ใช้ Context ที่ยาวขึ้น และรัน AI Agent หลายตัวพร้อมกันได้ โดยเฉพาะทีมขนาดเล็กที่ต้องการระบบ AI ส่วนกลางให้สมาชิกหลายคนเรียกใช้งานร่วมกัน
NVIDIA Sync เพิ่ม Model Launcher และเครื่องมือจัดการระบบ
ภายในเดือนตุลาคม NVIDIA เตรียมเพิ่ม Model Launcher ให้กับ NVIDIA Sync เพื่อช่วยให้ผู้ใช้ดาวน์โหลดโมเดลและคอนเทนเนอร์ที่เหมาะกับเครื่องหรือคลัสเตอร์ได้จากขั้นตอนที่ง่ายขึ้น พร้อมเชื่อมต่อโมเดลเข้ากับ OpenCode โดยอัตโนมัติ
ระบบยังโหลด DGX Spark Skills ซึ่งเป็นชุดคำแนะนำสำหรับแก้ไขปัญหา บำรุงรักษาอุปกรณ์ และเข้าถึงเอกสารทางการได้ด้วย
ส่วนอัปเดตซอฟต์แวร์เดือนตุลาคมจะเพิ่ม Wi-Fi Assistant ที่ช่วยเปลี่ยนเครือข่ายเมื่อ DGX Spark ทำงานในโหมด Appliance ทำให้การใช้งานในลักษณะอุปกรณ์ AI โดยเฉพาะสะดวกขึ้น
DGX Station ประมวลผล AI สูงสุด 20 PFLOPS รองรับหน่วยความจำ 748GB
DGX Station — เวิร์กสเตชัน AI สำหรับองค์กรและทีมขนาดใหญ่
748GB
Coherent Memory
20 PFLOPS
ประสิทธิภาพ AI สูงสุดตามที่ NVIDIA ระบุ
30+ ผู้ใช้
รองรับการให้บริการโมเดลแก่ผู้ใช้หลายคน
สำหรับองค์กรที่ต้องการพลังประมวลผลสูงขึ้น DGX Station รองรับ Coherent Memory ขนาด 748GB และประสิทธิภาพ AI สูงสุด 20 เพตะฟลอป โดย NVIDIA ระบุว่าสามารถให้บริการโมเดลอย่าง GLM 5.3 แก่ผู้ใช้มากกว่า 30 คนได้ ด้วยความเร็วที่บริษัทเปรียบเทียบว่าใกล้เคียงกับบริการโมเดลบนคลาวด์
การประกาศครั้งนี้ยังเพิ่มการรองรับ NVIDIA Sync สำหรับ DGX Station ช่วยให้เชื่อมต่อระบบ Linux สองเครื่องเข้าด้วยกัน และเพิ่มการเชื่อมต่อกับเครื่องมือบริหารจัดการระบบองค์กรอีก 7 รายการ ได้แก่ Absolute Security, Splunk, Fleet Device Management, Microsoft Intune, Perforce Puppet, Progress Software Chef และ Tanium
เป้าหมายคือช่วยให้ฝ่ายไอทีสามารถนำระบบ AI ไปอยู่ในกระบวนการติดตั้ง ตรวจสอบความปลอดภัย และบริหารจัดการอุปกรณ์ที่องค์กรใช้อยู่ได้ง่ายขึ้น
DGX Station เวอร์ชัน Windows มาเดือนธันวาคม
ประเด็นสำคัญสำหรับภาคธุรกิจคือ DGX Station for Windows ซึ่ง NVIDIA คาดว่าจะเริ่มส่งมอบผ่านผู้ผลิตพีซีในเดือนธันวาคม 2026
ระบบใหม่นี้ออกแบบมาให้ผู้ใช้รันโมเดลและ AI Agent ภายใน Windows พร้อมทำงานร่วมกับซอฟต์แวร์วิศวกรรมและการผลิตระดับมืออาชีพ โดยรายชื่อซอฟต์แวร์ที่ระบุว่ารองรับประกอบด้วย nTop, Dassault Systèmes, Keysight Technologies, MathWorks, Rockwell Automation, Siemens, Synopsys, Unity และ Altera
นอกจากนี้ยังรองรับการใช้งาน Agent อย่าง Hermes Agent, Perplexity และ Aible ภายในระบบขององค์กร เพื่อให้ AI สามารถทำงานกับเครื่องมือและข้อมูลในสภาพแวดล้อมที่องค์กรควบคุมเองได้
ส่วนงานหุ่นยนต์ NVIDIA เปิดตัวเวิร์กโฟลว์อ้างอิงแบบโอเพนซอร์ส 3 ชุดสำหรับ DGX Station ที่ผสาน GPT-6 Astra, Isaac Lab, Isaac Lab-Arena และ Cosmos ครอบคลุมการฝึกโมเดล GR00T 1.7 ด้วย Reinforcement Learning การฝึกทักษะการหยิบจับวัตถุอย่างละเอียด และการปรับแต่ง World Model เพื่อสร้างข้อมูลสังเคราะห์สำหรับการฝึก AI
อีกบริการที่กำลังจะเปิดให้ทดลองใช้คือ NVIDIA Cloud Functions บน DGX Station รุ่น Linux ซึ่งช่วยให้ทีมลงทะเบียนปลายทางโมเดลไว้ในแค็ตตาล็อกกลาง และเรียกใช้งานผ่านจุดเชื่อมต่อเดียวที่รองรับรูปแบบ OpenAI API โดยสามารถเปลี่ยนโมเดลที่อยู่เบื้องหลังได้โดยไม่จำเป็นต้องแก้ไขโค้ดของแอปพลิเคชัน
เปิดตัว Recursive Flint โมเดลเขียนโค้ด 40,000 ล้านพารามิเตอร์
อีกหนึ่งไฮไลต์ของงานคือ Recursive Flint โมเดลภาษาแบบ Mixture of Experts (MoE) สำหรับการเขียนโค้ดจาก Recursive Superintelligence ซึ่งมีพารามิเตอร์รวม 40,000 ล้านพารามิเตอร์ แต่เปิดใช้งานเพียง 2,500 ล้านพารามิเตอร์ต่อโทเคนตามโครงสร้างของโมเดล
แนวทางนี้ช่วยลดภาระการประมวลผลเมื่อเทียบกับการเปิดใช้งานพารามิเตอร์ทั้งหมดพร้อมกัน ทำให้เหมาะกับการรันโมเดลเขียนโค้ดบนฮาร์ดแวร์ Local AI
Recursive Flint ถูกพัฒนาด้วยระบบ Eureka Machine ซึ่งช่วยทำงานวิจัย AI แบบอัตโนมัติ ตั้งแต่เสนอแนวคิด ทดลองเขียนโค้ด รันการทดลอง ไปจนถึงนำผลลัพธ์กลับมาปรับปรุงรอบถัดไป โดย Recursive ระบุว่าการสร้าง Kernel เฉพาะทางช่วยเพิ่มความเร็วในการสร้างข้อความของโมเดลบน RTX Spark ได้ 55% โดยไม่ต้องเปลี่ยนน้ำหนักโมเดล
ผู้พัฒนาสามารถดาวน์โหลดน้ำหนักโมเดลผ่าน Hugging Face ภายใต้สัญญาอนุญาต Apache 2.0 และนำไปใช้งานกับ RTX Spark, DGX Spark, GeForce RTX และ RTX PRO GPU ได้ รวมถึงปรับแต่งโมเดลเพิ่มเติมด้วย NeMo Automodel และ NeMo RL
เพิ่ม Day-One Support ให้โมเดล AI รุ่นใหม่หลายค่าย
NVIDIA ยังประกาศรองรับโมเดล AI รุ่นใหม่ตั้งแต่วันแรกสำหรับฮาร์ดแวร์ Local AI ครอบคลุม NVIDIA Nemotron Bolt E4B, GLM, DeepSeek, Qwen, MiniMax, Liquid AI LFM2.5-24B-A2B และ FLUX.3 Klein
จุดเด่นของแต่ละกลุ่มมีดังนี้
-
Nemotron Bolt E4B: โมเดลขนาดเล็กสำหรับบทสนทนาและ AI Agent แบบหลายรอบ สนับสนุนผู้ช่วยเสียง AI ตัวละครในเกม และอินเทอร์เฟซแบบฝังตัว โดย NVIDIA ระบุว่าสามารถทำงานในหน่วยความจำเพียง 4GB ได้
-
FLUX.3 Klein: โมเดลสร้างและแก้ไขภาพแบบ Open Weights ขนาด 5,600 ล้านพารามิเตอร์ รุ่นที่ได้รับการปรับแต่งโดย NVIDIA สามารถทำงานบน GeForce RTX ที่มี VRAM 8GB และสร้างภาพขนาด 1 เมกะพิกเซลได้ประมาณ 4 วินาทีบน RTX 5090
-
MiniMax M3.1 Flash: โมเดลสำหรับ DGX Station และ DGX Spark ที่เน้นการทำงานกับ Context ขนาดยาว
-
Liquid AI LFM2.5-24B-A2B: โมเดล Reasoning ขนาด 24,000 ล้านพารามิเตอร์ที่เปิดใช้งานเพียง 2,000 ล้านพารามิเตอร์ต่อโทเคน เหมาะกับการรัน AI Agent ที่เรียกใช้เครื่องมือได้บนพีซี
นอกจากนี้ NVIDIA ยังเผยแพร่ชุด Model Checkpoints ที่ผ่านการ Quantization เพื่อใช้หน่วยความจำอย่างมีประสิทธิภาพมากขึ้น โดยมีเป้าหมายให้โมเดลขนาดใหญ่ทำงานได้โดยเหลือพื้นที่สำหรับ KV Cache ซึ่งจำเป็นต่อการประมวลผล Context ของโมเดลภาษา
เร่ง llama.cpp และ vLLM เพิ่มความเร็วงาน AI สูงสุด 1.4 เท่า
NVIDIA ยังคงทำงานร่วมกับชุมชนโอเพนซอร์สเพื่อเร่งความเร็วของเอนจิน AI Inference โดยเฉพาะ llama.cpp และ vLLM ซึ่งถูกใช้อย่างแพร่หลายในการรันโมเดลภาษาและ AI Agent บนฮาร์ดแวร์ของผู้ใช้เอง
ผลการปรับปรุงที่ NVIDIA ระบุ ได้แก่
|
เอนจินและโมเดล |
ฮาร์ดแวร์ |
ความเร็วที่เพิ่มขึ้น |
|---|---|---|
|
llama.cpp — Qwen 3.8 Flash Next |
RTX PRO 6000 Blackwell |
สูงสุด 1.4 เท่า |
|
vLLM — Qwen3.8 27B |
DGX Spark |
สูงสุด 1.3 เท่า |
|
vLLM — GLM 5.3 Flash |
DGX Station |
Throughput สูงสุด 1.2 เท่า |
การปรับปรุงเหล่านี้มาจากเทคนิค Speculative Decoding, MTP และ Kernel สำหรับการประมวลผล Attention บางส่วน ช่วยให้ AI Agent ทำงานต่อเนื่องได้เร็วขึ้น ทั้งในงานเขียนโค้ดและงานที่ต้องใช้โมเดลภาษาเป็นตัวช่วยตัดสินใจ
NVIDIA กำลังผลักดันให้ Local AI เป็นระบบที่ใช้งานจริงได้ครบวงจร
ภาพรวมจาก GTC Berlin ครั้งนี้ชัดเจนว่า NVIDIA ไม่ได้มอง Local AI เป็นเพียงการนำโมเดลภาษาไปรันบนการ์ดจออีกต่อไป แต่กำลังสร้างระบบที่ครอบคลุมตั้งแต่พีซีสำหรับผู้ใช้ทั่วไปและครีเอเตอร์ ไปจนถึงคลัสเตอร์สำหรับนักพัฒนาและเวิร์กสเตชันสำหรับองค์กร
RTX Spark เน้นการรัน AI Agent บน Windows และเก็บข้อมูลไว้ในเครื่อง, DGX Spark เปิดทางให้ทีมพัฒนาเพิ่มขีดความสามารถด้วยการเชื่อมต่อหลายระบบ ส่วน DGX Station มุ่งตอบโจทย์งาน AI ขนาดใหญ่ การพัฒนาหุ่นยนต์ และการให้บริการโมเดลภายในองค์กร
สิ่งที่ต้องติดตามต่อไปคือราคา ต้นทุนการเป็นเจ้าของระบบ และประสิทธิภาพจริงในการใช้งานระยะยาว เพราะแม้ Local AI จะช่วยลดการพึ่งพาคลาวด์และเพิ่มการควบคุมข้อมูล แต่การสร้างระบบที่รองรับโมเดลขนาดใหญ่ให้ใช้งานได้อย่างรวดเร็วและคุ้มค่าก็ยังต้องอาศัยทั้งฮาร์ดแวร์ ซอฟต์แวร์ และการจัดการหน่วยความจำที่เหมาะสมควบคู่กันไป