CRAM อาจเปลี่ยนวิธีใช้ RAM บน Linux อ้างประสิทธิภาพสูงกว่า ZRAM สูงสุด 452 เท่า
วงการ Linux กำลังมีแนวคิดใหม่สำหรับการเพิ่มประสิทธิภาพหน่วยความจำ เมื่อทีมวิจัยจาก Meta นำเสนอระบบชื่อ CRAM หรือโมเดลการบีบอัดหน่วยความจำแนวทางใหม่ ที่พยายามหลีกเลี่ยงต้นทุนจาก Swap โดยเก็บข้อมูลที่ถูกบีบอัดไว้ใน RAM โดยตรง
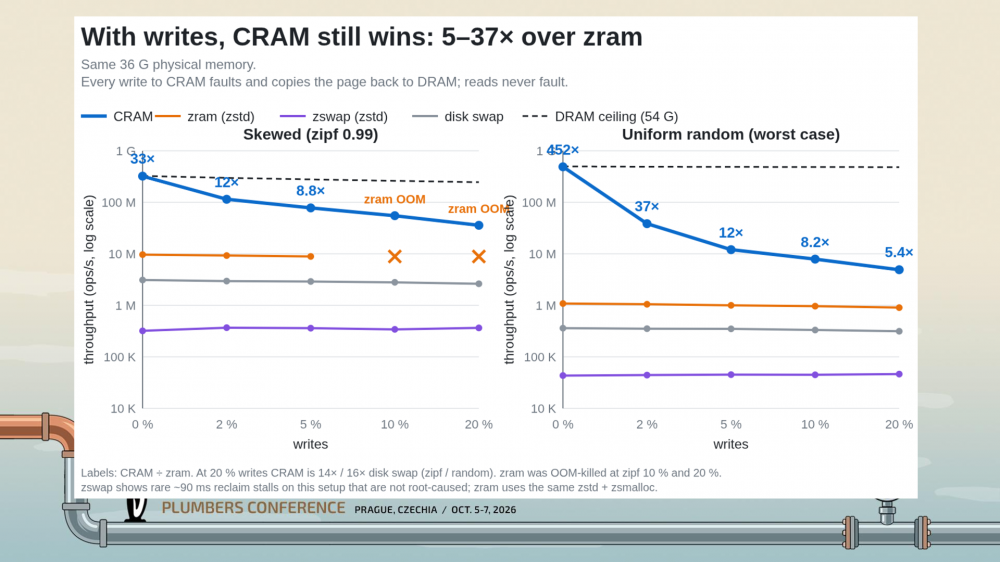
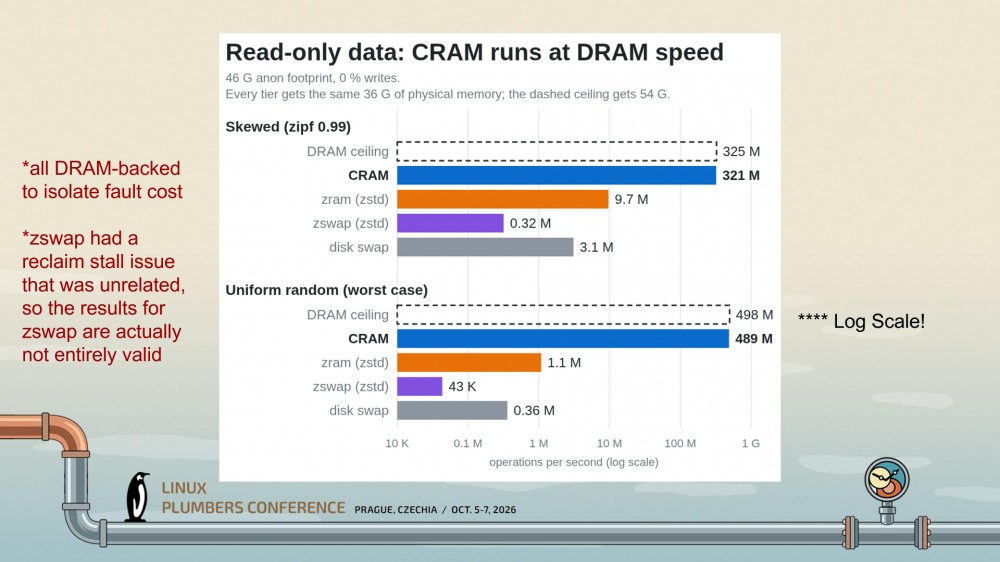
ข้อมูลจากงานนำเสนอที่ Linux Plumbers Conference ระบุว่า CRAM สามารถให้ประสิทธิภาพสูงกว่า ZRAM ได้สูงสุดถึง 452 เท่า ในบางสถานการณ์ โดยเฉพาะงานที่มีการอ่านข้อมูลจากหน่วยความจำบีบอัดบ่อยครั้ง
แนวคิดนี้อาจฟังดูคล้ายกับ ZRAM ในตอนแรก แต่สถาปัตยกรรมภายในแตกต่างกันอย่างมาก และนี่คือจุดที่ทำให้ CRAM ถูกจับตามอง
ปัญหาอาจไม่ได้อยู่ที่การบีบอัด
การบีบอัด RAM ไม่ใช่เทคโนโลยีใหม่ เพราะระบบปฏิบัติการหลายตัวสามารถเก็บข้อมูลในรูปแบบ compressed memory ได้มานานแล้ว
สำหรับ Linux เครื่องมือที่พบได้บ่อยคือ zswap และ ZRAM
แนวคิดพื้นฐานคือ เมื่อ RAM เริ่มตึง ระบบสามารถบีบอัดข้อมูลบางส่วนเพื่อลดพื้นที่ที่ต้องใช้ แทนที่จะปล่อยให้ข้อมูลถูกเขียนลง Storage ซึ่งช้ากว่ามาก
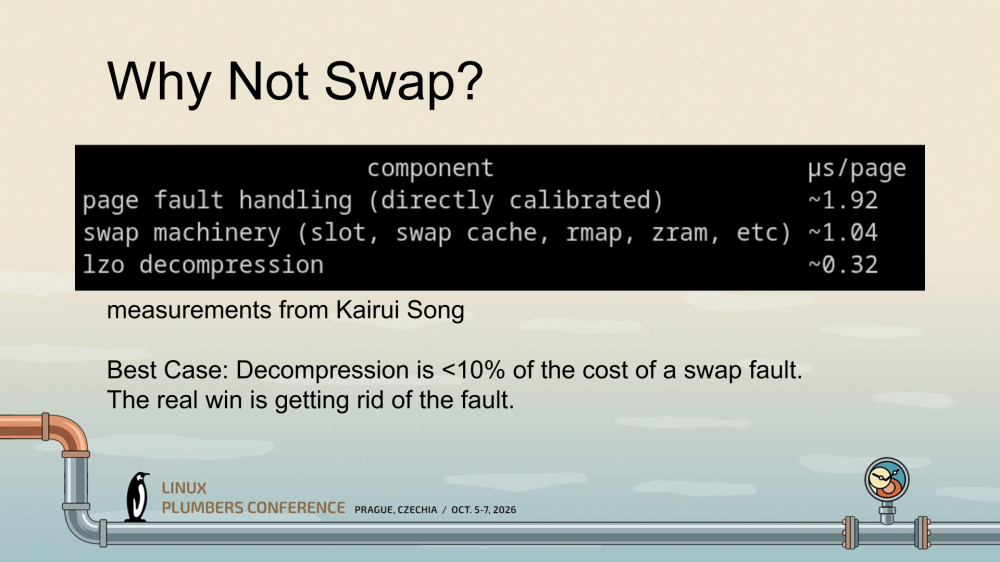
แต่ Gregory Price และทีมจาก Meta มองว่าต้นทุนที่สำคัญของ compressed memory อาจไม่ได้มาจากขั้นตอน Compression และ Decompression โดยตรง เพราะส่วนนี้ใช้เวลาไม่มากนัก
สิ่งที่สร้างต้นทุนมากกว่ากลับเป็น Memory Fault และพฤติกรรมของ Swap Layer
ดังนั้นแนวคิดของ CRAM จึงเกิดขึ้นจากคำถามง่าย ๆ ว่า
ถ้าเราทำ ZRAM แต่ไม่ใช้มันในฐานะ Swap Device ล่ะ?
CRAM ไม่ทำตัวเป็น Block Device
ZRAM ทำงานในลักษณะสร้างอุปกรณ์ Block Device เสมือนขึ้นมา แล้วให้ Linux มองข้อมูลที่ถูกบีบอัดเป็นพื้นที่ Swap
แนวทางนี้ใช้งานได้ดี แต่หมายความว่าการเข้าถึงข้อมูลยังต้องผ่านกลไกของ Swap Layer ซึ่งสร้าง Overhead ในตัวมันเอง
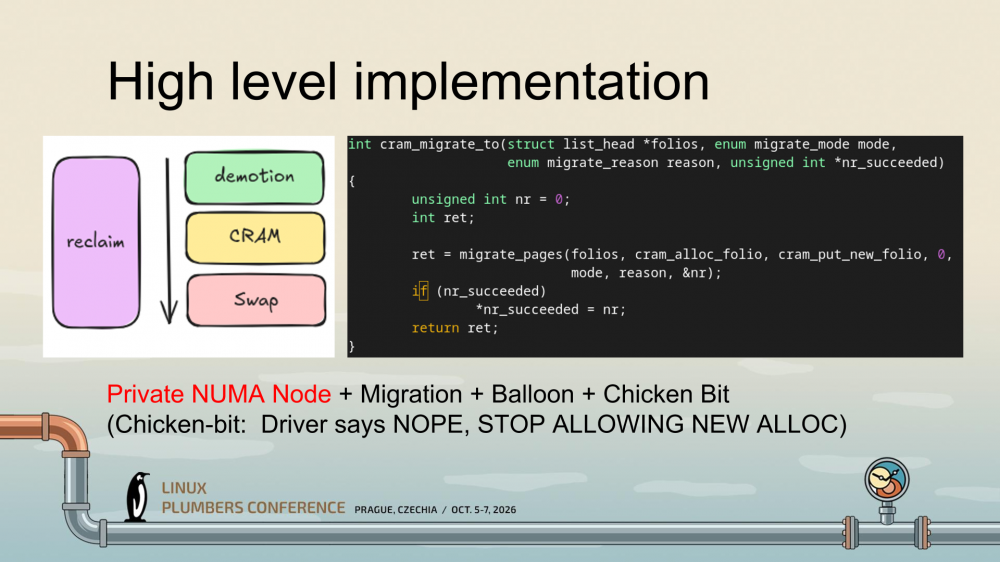
CRAM เลือกเส้นทางที่แตกต่างออกไป โดยใช้ Private NUMA Node เป็นพื้นที่สำหรับเก็บข้อมูลที่ถูกบีบอัด แทนที่จะจำลองตัวเองเป็น Block Device
NUMA Node ดังกล่าวสามารถมองในเชิงง่าย ๆ ได้ว่าเป็นเหมือน “CPU เสมือน” หรือโหนดหน่วยความจำพิเศษที่ Linux สามารถจัดการผ่านกลไก Memory Management ที่มีอยู่แล้ว
แนวทางนี้ทำให้ CRAM สามารถใช้กลไกที่ Linux มีอยู่ เช่น Memory Migration และ Ballooning เพื่อบริหารพื้นที่หน่วยความจำที่ถูกบีบอัดได้โดยตรง
เป้าหมายคือทำให้การเข้าถึงข้อมูลมีต้นทุนต่ำกว่าแนวทางที่ต้องวนผ่าน Swap
ทำไมถึงเคลมว่าเร็วกว่า ZRAM ได้มากขนาดนั้น?
ตัวเลข 452 เท่า ฟังดูรุนแรงมาก แต่ไม่ได้หมายความว่า CRAM จะทำให้ทุกโปรแกรมบน Linux เร็วขึ้น 452 เท่า
ตัวเลขดังกล่าวมาจากผลการเปรียบเทียบใน Workload และเงื่อนไขที่กำหนดไว้ ซึ่งประโยชน์หลักของ CRAM อยู่ที่การลด Overhead จาก Swap และ Fault Handling
โดยเฉพาะ Read Path ซึ่งเป็นจุดที่ CRAM สามารถหลีกเลี่ยงเส้นทางการทำงานบางส่วนของระบบ Swap ได้
ดังนั้นควรตีความตัวเลขนี้ว่าเป็น Maximum Improvement ในสถานการณ์เฉพาะ มากกว่าจะนำไปใช้เป็นตัวเลขประสิทธิภาพทั่วไป
มี "Chicken Bit" เอาไว้หยุดระบบก่อนพัง
หนึ่งในรายละเอียดที่น่าสนใจที่สุดของ CRAM คือกลไกที่ทีมเรียกว่า Chicken Bit
ชื่ออาจฟังดูเหมือนเรื่องเล่น ๆ แต่หน้าที่ของมันจริงจังค่อนข้างมาก
ปัญหาคือข้อมูลแต่ละประเภทมีความสามารถในการบีบอัดไม่เท่ากันเลย
ข้อมูลที่เต็มไปด้วยเลขศูนย์สามารถบีบอัดได้อย่างมหาศาล ขณะที่ไฟล์หรือข้อมูลที่ถูกบีบอัดมาแล้ว เช่น JPEG, MP4 หรือ ZIP อาจแทบไม่สามารถลดขนาดลงได้อีก
นั่นทำให้เกิดปัญหาสำคัญว่า
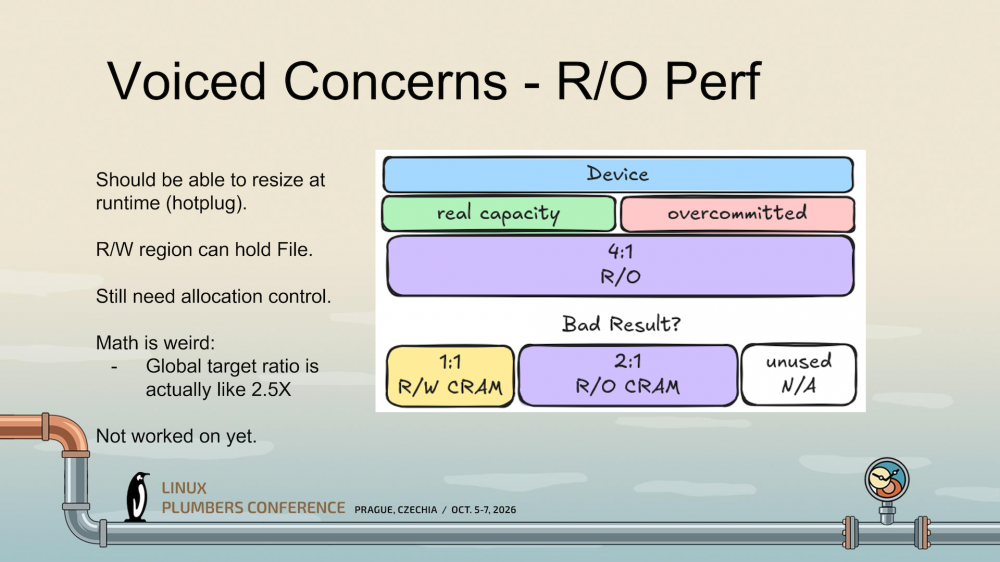
ถ้า RAM 16GB สามารถบีบอัดได้ไม่เท่ากัน เราจะนับว่าเครื่องมี "RAM ที่ใช้งานได้จริง" กี่ GB?
คำตอบคือยังไม่มีวิธีที่สมบูรณ์แบบ
และจากข้อมูลที่นำเสนอ ปัญหาเรื่องการประเมินพื้นที่แบบ Logical Capacity ของ CRAM ยังถือเป็น โจทย์วิจัยที่แก้ไม่สมบูรณ์
ป้องกัน "Poison Storm"
เมื่อข้อมูลที่ถูกเขียนเข้ามามีอัตราเร็วสูงกว่าความสามารถของ CRAM ในการจัดสรรพื้นที่ ระบบอาจเข้าสู่สถานการณ์ที่ Allocation เริ่มล้มเหลวต่อเนื่อง
ปัญหานี้อาจลุกลามจนเกิด Failure เป็นลูกโซ่ ซึ่งในการนำเสนอถูกเรียกอย่างน่าสนใจว่า "Poison Storm"
Chicken Bit จึงทำหน้าที่เหมือนสวิตช์ฉุกเฉิน บอก Linux ว่า หยุดพยายามใช้ CRAM ชั่วคราว เมื่อระบบกำลังยุ่งกับการจัดสรรหน่วยความจำหรือสถานการณ์เริ่มไม่ปลอดภัย
แนวทางนี้ไม่ได้แก้ปัญหาพื้นที่หน่วยความจำแบบถาวร แต่ช่วยป้องกันไม่ให้ระบบพยายามใช้ทรัพยากรที่ CRAM ไม่สามารถจัดหาได้จนเกิดความล้มเหลวแบบต่อเนื่อง
จุดเด่นคืออ่านข้อมูลได้โดยไม่ต้องเดินทางผ่าน Swap
สิ่งที่ CRAM พยายามแก้จึงไม่ใช่แค่ “Compress RAM ให้ได้มากขึ้น”
แต่เป็นการลดขั้นตอนที่ Linux ต้องทำเพื่อเข้าถึงข้อมูลที่ถูกบีบอัด
ในระบบแบบ ZRAM ข้อมูลที่ถูกบีบอัดยังมีสถานะใกล้เคียงกับ Swap และต้องทำงานผ่านกลไกที่เกี่ยวข้องกับ Virtual Memory และ Page Fault
CRAM พยายามเก็บข้อมูลไว้เป็นส่วนหนึ่งของระบบ Memory Management โดยตรง ทำให้ Linux สามารถใช้ Semantics ของหน่วยความจำที่มีอยู่แล้วได้มากกว่า
หากแนวทางนี้สามารถพัฒนาให้เสถียรได้จริง ก็มีโอกาสที่จะทำให้ compressed memory กลายเป็นส่วนหนึ่งของ Memory Management ที่เป็นธรรมชาติมากขึ้น แทนที่จะเป็นเพียง Swap Layer ที่ถูกดัดแปลงให้เร็วขึ้น
แต่ CRAM ยังไม่ใช่ของที่จะมาแทน ZRAM พรุ่งนี้
แม้ผลเบื้องต้นจะน่าสนใจมาก แต่ CRAM ยังอยู่ในระดับ งานวิจัยและการพัฒนา
ปัญหาใหญ่ที่สุดคือการจัดการ Capacity ที่ไม่แน่นอน เนื่องจาก Compression Ratio ของข้อมูลเปลี่ยนแปลงตลอดเวลา และระบบต้องสามารถตัดสินใจได้ว่าเมื่อใดควรใช้ CRAM เมื่อใดควรหยุดใช้ และควรจัดสรรพื้นที่อย่างไรไม่ให้ Memory Pressure กลายเป็นปัญหาใหม่
นอกจากนี้ยังต้องพิสูจน์ประสิทธิภาพกับ Workload ที่หลากหลายมากกว่าการทดสอบในสภาพแวดล้อมที่ออกแบบมาเฉพาะ
แต่แนวคิดของ CRAM ก็น่าสนใจเพราะมันกำลังตั้งคำถามกับสมมติฐานเดิมของ Compressed Memory ว่า
จำเป็นจริงหรือที่ข้อมูลที่บีบอัดต้องถูกจัดการเหมือน Swap?
ถ้าคำตอบคือ “ไม่จำเป็น” CRAM อาจเปิดแนวทางใหม่ให้ Linux จัดการหน่วยความจำบีบอัดได้มีประสิทธิภาพกว่าเดิม โดยเฉพาะในระบบที่มี RAM จำกัด แต่ต้องรองรับ Workload ขนาดใหญ่
และที่สำคัญคือ แนวคิดนี้ไม่ได้พยายามเพิ่ม RAM ทางกายภาพ แต่พยายามทำให้ RAM เดิมมีประสิทธิภาพมากขึ้น
หากทีม Meta สามารถแก้โจทย์เรื่อง Capacity และเสถียรภาพได้สำเร็จ CRAM อาจกลายเป็นหนึ่งในเทคโนโลยีที่น่าสนใจมากสำหรับเครื่องที่มี RAM จำกัด ตั้งแต่ PC, Server ไปจนถึงระบบ Cloud ที่ต้องการรีดประโยชน์จากหน่วยความจำทุกไบต์ให้ได้มากที่สุด
ที่มา: Tom's Hardware