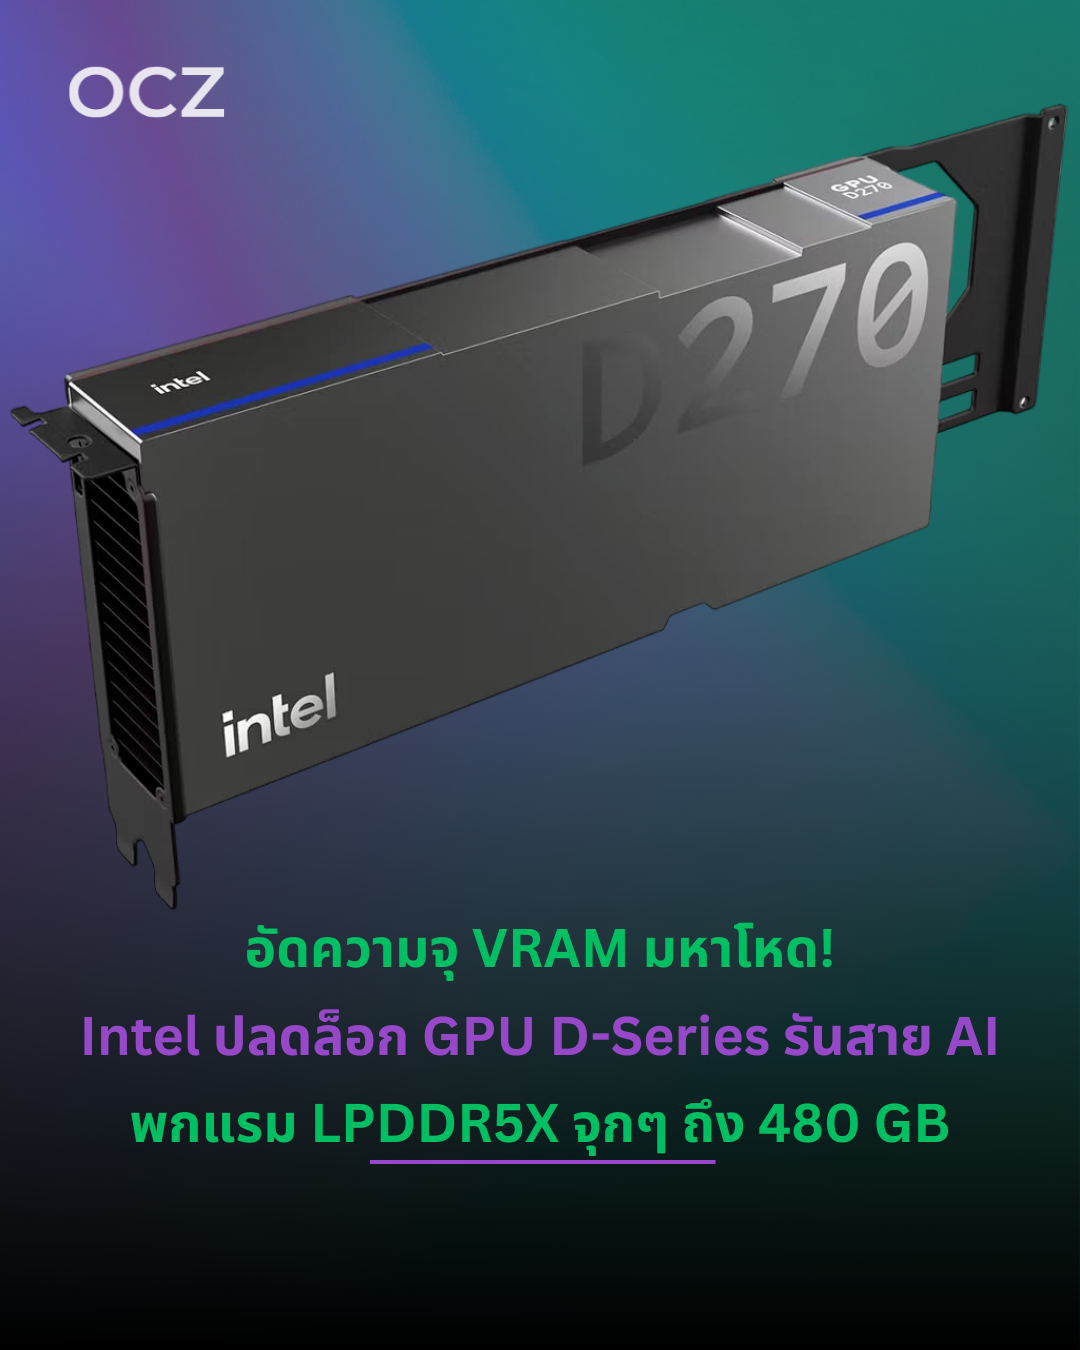
Intel เปิดตัว GPU D-Series “Crescent Island” อัด RAM 480GB แรง 1.3 PFLOPS กินไฟ 350W ท้าชนตลาด AI Inference
Intel เปิดเผยรายละเอียดอย่างเป็นทางการของ Intel GPU D-Series ซึ่งใช้ชื่อรหัสเดิมว่า Crescent Island แพลตฟอร์มเร่งประมวลผล AI รุ่นใหม่ที่ออกแบบมาเพื่อการประมวลผล Inference โดยเฉพาะ พร้อมเผยสเปกที่น่าสนใจ ทั้งหน่วยความจำ LPDDR5X สูงสุดถึง 480GB, พลังประมวลผล FP8 สูงสุด 1.3 PFLOPS และใช้พลังงานเพียง 350W ภายใต้ระบบระบายความร้อนด้วยอากาศ
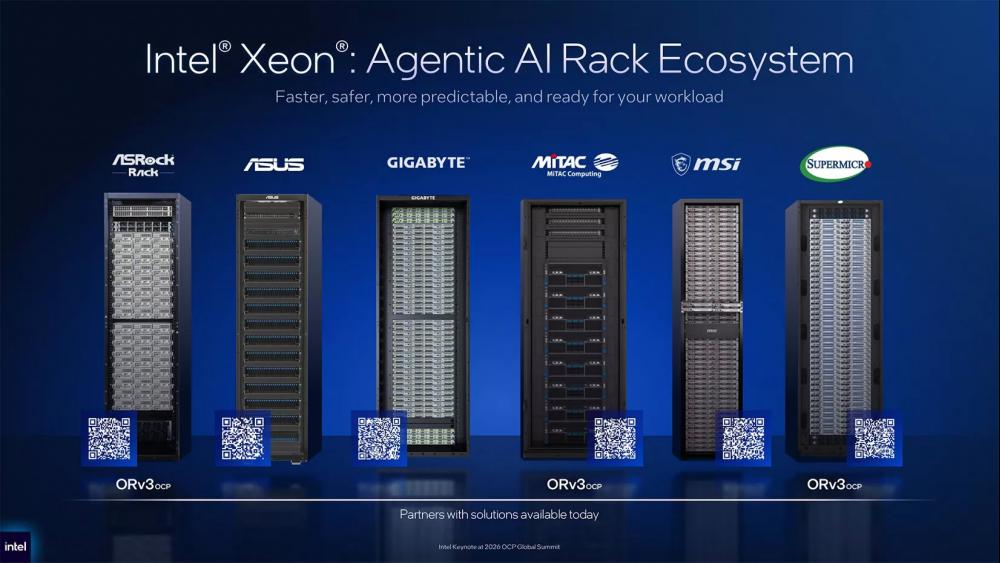
การเปิดเผยครั้งนี้เกิดขึ้นภายในงาน Open Compute Project (OCP) Global Summit 2026 โดย Intel ต้องการนำเสนอทางเลือกสำหรับองค์กรที่ต้องการรันโมเดล AI ขนาดใหญ่และระบบ AI Agent โดยไม่จำเป็นต้องลงทุนกับโครงสร้างพื้นฐานที่ใช้ GPU หน่วยความจำ HBM ราคาแพงหรือระบบระบายความร้อนด้วยของเหลวโดยเฉพาะ
โปรเจกต์นี้มีความสำคัญต่อ Intel เพราะที่ผ่านมาแผนพัฒนา GPU สำหรับ Data Center หลายรุ่นต้องหยุดชะงักหรือถูกยกเลิก ทำให้บริษัทต้องหาทางกลับเข้าสู่ตลาด AI Accelerator อีกครั้ง โดยเน้นจุดแข็งเรื่องความจุหน่วยความจำ ต้นทุน และการนำไปติดตั้งในเซิร์ฟเวอร์ที่มีอยู่เดิม
Xe3P สถาปัตยกรรมที่ออกแบบมาเพื่อ AI โดยเฉพาะ
Intel GPU D-Series ใช้สถาปัตยกรรม Xe3P ซึ่งพัฒนาต่อยอดจากตระกูล Xe โดยเน้นการประมวลผล AI มากกว่าการเรนเดอร์กราฟิกสำหรับเล่นเกม
ตัวชิปประกอบด้วย Xe3P Cores จำนวน 32 คอร์ พร้อม XMX Engines จำนวน 256 ชุด และ Unified L2 Cache ขนาด 32MB
จุดที่น่าสนใจคือการออกแบบ XMX Engines ใหม่ จากสถาปัตยกรรม Xe3 ทั่วไปที่ใช้แนวทาง Systolic Pipeline แบบ 4 ชั้น มาเป็นการประมวลผลแบบ 16 ชั้นใน Xe3P เพื่อมุ่งเน้นงานคำนวณเมทริกซ์และ AI โดยเฉพาะ
แต่ละ Xe3P Core ยังมี Register File ขนาด 1MB และ L1 Cache ขนาด 512KB ขณะที่ระบบโดยรวมประกอบด้วย Vector Engines จำนวน 256 ชุด และ XMX Engines อีก 256 ชุด
ที่สำคัญ Xe3P ตัดองค์ประกอบที่ใช้สร้างภาพสำหรับการแสดงผลออกไป เพราะการ์ดรุ่นนี้ไม่ได้ถูกออกแบบมาให้ใช้เล่นเกมหรือส่งสัญญาณภาพไปยังจอ แต่เน้นทำงาน AI Inference ซึ่งเป็นกระบวนการนำโมเดลที่ผ่านการฝึกมาแล้วไปประมวลผลคำสั่งและสร้างผลลัพธ์ เช่น การสร้างข้อความ การตอบคำถาม และการทำงานของ AI Agent
VRAM สูงสุด 480GB ใช้ LPDDR5X แทน HBM
จุดขายสำคัญที่สุดของ GPU D-Series คือความจุหน่วยความจำขนาดใหญ่ โดยใช้ LPDDR5X สูงสุด 480GB พร้อมแบนด์วิดท์หน่วยความจำสูงถึง 1.5TB/s
การเลือกใช้ LPDDR5X แทน HBM แสดงให้เห็นว่า Intel ต้องการสร้างสมดุลระหว่างความจุ ต้นทุน และการใช้พลังงานสำหรับงาน Inference ที่ต้องเก็บข้อมูลโมเดลจำนวนมากไว้ในหน่วยความจำตลอดเวลา
สำหรับการ์ดที่ Intel จำหน่ายภายใต้แบรนด์ของบริษัท จะติดตั้งหน่วยความจำมาให้ 160GB ขณะที่ผู้ผลิตเซิร์ฟเวอร์และ ODM สามารถออกแบบการ์ดที่มีหน่วยความจำได้สูงสุด 480GB ตามข้อมูลที่ Intel เปิดเผย
ความจุระดับนี้ช่วยให้การ์ดสามารถรองรับโมเดลภาษาขนาดใหญ่ได้ โดย Intel ระบุว่าสามารถรันโมเดลที่มีพารามิเตอร์ได้สูงสุดประมาณ 300,000 ล้านพารามิเตอร์บนการ์ดเพียงใบเดียว ส่วนระบบที่เชื่อมต่อ GPU จำนวน 8 ใบ สามารถรองรับโมเดลที่มีพารามิเตอร์มากกว่า 1 ล้านล้านตัวได้
อย่างไรก็ตาม ความสามารถในการรันโมเดลจริงยังขึ้นอยู่กับรูปแบบ Quantization, Context Length, KV Cache, ขนาด Batch และซอฟต์แวร์ที่ใช้งาน ไม่ได้ขึ้นอยู่กับจำนวนพารามิเตอร์หรือหน่วยความจำเพียงอย่างเดียว
แรง 1.3 PFLOPS แต่กินไฟ 350W
Intel ระบุว่า GPU D-Series ให้ประสิทธิภาพการประมวลผลสูงสุด 1.3 PFLOPS ในรูปแบบ FP8 และรองรับรูปแบบการคำนวณตั้งแต่ FP4 ไปจนถึง FP64 เพื่อรองรับงาน AI และงานคำนวณประเภทอื่นที่ต้องการระดับความแม่นยำแตกต่างกัน
ตัวเลข 1.3 PFLOPS เป็นประสิทธิภาพสูงสุดตามรูปแบบการคำนวณ FP8 ไม่ใช่ตัวเลขที่ใช้แทนประสิทธิภาพทุกประเภทงานโดยตรง โดยผลลัพธ์จริงจะขึ้นอยู่กับโมเดล ซอฟต์แวร์ และการใช้ประโยชน์จากฮาร์ดแวร์
ด้านระบบระบายความร้อน ตัวการ์ดได้รับการออกแบบให้ใช้พลังงานอยู่ในระดับ 350W พร้อมระบบระบายความร้อนด้วยอากาศ ไม่จำเป็นต้องใช้ระบบ Liquid Cooling เฉพาะทาง ทำให้สามารถติดตั้งลงในเซิร์ฟเวอร์มาตรฐานที่รองรับ PCIe 5.0 x16 ได้ง่ายกว่าแพลตฟอร์มที่ต้องใช้ระบบระบายความร้อนซับซ้อน
นี่ถือเป็นจุดสำคัญสำหรับองค์กรที่ต้องการเพิ่มจำนวน AI Accelerator ใน Data Center โดยไม่ต้องปรับปรุงระบบไฟฟ้าและระบบทำความเย็นครั้งใหญ่
มี Media Engine สำหรับ AI ที่ต้องทำงานกับวิดีโอ
แม้ GPU D-Series จะเน้น AI Inference แต่ Intel ยังติดตั้ง Media Engine ที่มีตัวเข้ารหัสวิดีโอ 4 ชุด และตัวถอดรหัสวิดีโออีก 4 ชุด
องค์ประกอบนี้ช่วยเพิ่มความยืดหยุ่นในการใช้งานกับระบบ AI แบบ Multimodal ซึ่งต้องประมวลผลข้อมูลหลายประเภทพร้อมกัน เช่น ข้อความ ภาพ และวิดีโอ รวมถึงงานที่ต้องทำความเข้าใจหรือสร้างเนื้อหาจากวิดีโอ
นอกจากนี้ Intel ยังใช้ซอฟต์แวร์พื้นฐานร่วมกันในตระกูล Xe และรองรับ AI Framework ที่มีอยู่แล้ว เพื่อช่วยให้นักพัฒนานำระบบไปใช้งานได้โดยไม่ต้องเริ่มต้นพัฒนาซอฟต์แวร์ใหม่ทั้งหมด
อย่างไรก็ตาม ความสำเร็จของ GPU D-Series จะขึ้นอยู่กับความสมบูรณ์ของไดรเวอร์ ไลบรารี และการรองรับ Framework ต่าง ๆ ด้วย เพราะฮาร์ดแวร์ที่มีประสิทธิภาพสูงอาจไม่ได้ให้ผลลัพธ์ตามที่คาดหวัง หากซอฟต์แวร์ยังไม่สามารถใช้ทรัพยากรได้เต็มที่
สเปก Intel GPU D-Series (Crescent Island)
| รายการ | รายละเอียด |
|---|---|
| ผลิตภัณฑ์ | Intel GPU D-Series |
| ชื่อรหัส | Crescent Island |
| สถาปัตยกรรม | Xe3P |
| Xe3P Cores | 32 คอร์ |
| XMX Engines | 256 ชุด |
| Unified L2 Cache | 32MB |
| หน่วยความจำ | LPDDR5X |
| หน่วยความจำรุ่น Intel | 160GB |
| หน่วยความจำสูงสุดสำหรับ ODM | 480GB |
| Memory Bandwidth | 1.5TB/s |
| ประสิทธิภาพ FP8 สูงสุด | 1.3 PFLOPS |
| รูปแบบคำนวณ | FP4 ถึง FP64 |
| Media Engine | 4 Encoders / 4 Decoders |
| อินเทอร์เฟซ | PCIe 5.0 x16 |
| การใช้พลังงาน | 350W |
| ระบบระบายความร้อน | Air Cooling |
| โมเดล AI บนการ์ดเดียว | สูงสุด 300B Parameters ตามข้อมูล Intel |
| โมเดล AI ในระบบ 8 GPU | มากกว่า 1T Parameters ตามข้อมูล Intel |
| สถานะ | เริ่มส่งตัวอย่างให้ลูกค้าแล้ว |
Intel กลับมาท้าชนตลาด AI แต่ยังต้องพิสูจน์ด้วยผลทดสอบจริง
การเปิดตัว GPU D-Series เป็นความพยายามของ Intel ในการกลับเข้าสู่ตลาด AI Accelerator ด้วยแนวทางที่แตกต่างจากการแข่งขันด้านพลังประมวลผลเพียงอย่างเดียว โดยเลือกให้ความสำคัญกับความจุหน่วยความจำ ต้นทุนต่อการสร้าง Token และความสามารถในการทำงานต่อเนื่องภายใต้ข้อจำกัดด้านพลังงาน
หาก Intel สามารถทำให้การ์ดมีราคาที่แข่งขันได้และซอฟต์แวร์ทำงานได้อย่างเสถียร GPU D-Series ก็อาจกลายเป็นทางเลือกสำหรับผู้ให้บริการ AI, Enterprise Data Center และผู้ให้บริการโมเดลแบบ Open Model ที่ต้องการเพิ่มปริมาณการให้บริการโดยควบคุมต้นทุน
ขณะนี้ Intel ระบุว่าเริ่มส่งตัวอย่างให้ลูกค้าแล้ว แต่ยังไม่ได้เปิดเผยราคาจำหน่าย กำหนดการวางจำหน่ายทั่วไป หรือผลทดสอบประสิทธิภาพจากบุคคลที่สาม
บทสรุป: Intel GPU D-Series ไม่ใช่การ์ดจอสำหรับเกมเมอร์ แต่เป็น AI Accelerator ที่เดิมพันกับหน่วยความจำ LPDDR5X สูงสุด 480GB และประสิทธิภาพ FP8 1.3 PFLOPS โดยใช้พลังงาน 350W จุดตัดสินสำคัญหลังจากนี้จึงไม่ใช่แค่ตัวเลขสเปกบนกระดาษ แต่คือความเร็วในการสร้าง Token ต้นทุนต่อ Token และความพร้อมของซอฟต์แวร์เมื่อใช้งานจริงในระบบ AI ขนาดใหญ่
ที่มา: TechPowerUp