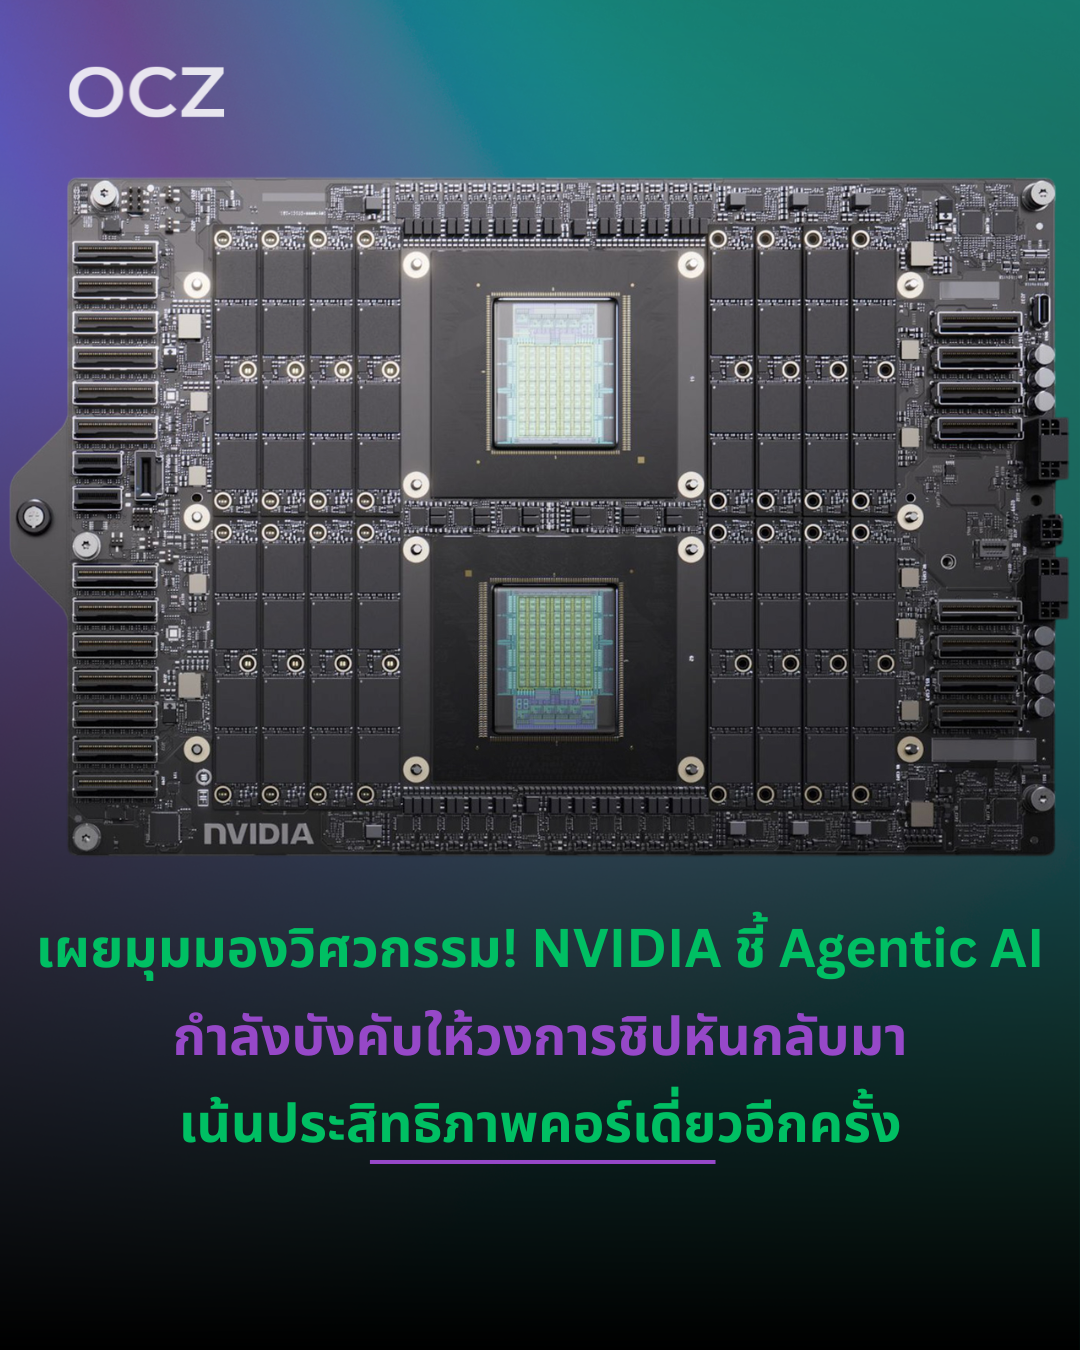
NVIDIA ชู Vera CPU พลิกเกมเซิร์ฟเวอร์ AI! ดัน Single-Core แรงขึ้น 50% พร้อมแบนด์วิดท์ระหว่างคอร์ 3.4TB/s รับยุค AI Agent
NVIDIA กำลังผลักดันแนวคิดการออกแบบซีพียูสำหรับดาต้าเซ็นเตอร์ครั้งใหม่ โดยมองว่าในยุคที่ AI Agent ต้องทำงานหลายขั้นตอนต่อเนื่องกัน ซีพียูไม่ควรทำหน้าที่เพียงป้อนข้อมูลให้ GPU อีกต่อไป แต่ต้องกลายเป็นหน่วยประมวลผลหลักที่จัดการคำสั่ง ลำดับงาน และกระบวนการคิดของ AI Agent ให้รวดเร็วที่สุด เพื่อไม่ให้ GPU ราคาแพงต้องหยุดรอซีพียู
แนวคิดนี้เป็นหัวใจสำคัญของ NVIDIA Vera CPU ซึ่งบริษัทออกแบบขึ้นเพื่อรองรับงาน Agentic AI โดยเฉพาะ พร้อมเปิดเผยรายละเอียดเพิ่มเติมในการสัมภาษณ์กับ Wccftech ทั้งเรื่องประสิทธิภาพต่อคอร์ สถาปัตยกรรมชิปแบบ Die เดียว ระบบหน่วยความจำแบนด์วิดท์สูง และการพัฒนาซีพียูแบบติดตั้งแยกเป็นแร็กสำหรับงาน AI โดยเฉพาะ
NVIDIA ระบุว่า Vera ให้ประสิทธิภาพโดยรวมสูงกว่า Grace รุ่นก่อนหน้าถึง 1.5 เท่า และสามารถเร็วกว่าโปรเซสเซอร์ x86 ชั้นนำได้สูงสุด 2 เท่าในงาน Agentic AI บางประเภท โดยเฉพาะงานที่ต้องประมวลผลตามลำดับ เช่น การรันสคริปต์ Python และการคอมไพล์โค้ด
จากยุคเน้นจำนวนคอร์ สู่ยุคที่ความเร็วต่อคอร์กลับมาสำคัญ
NVIDIA อธิบายว่า ช่วงต้นทศวรรษ 2010 ตลาดซีพียูดาต้าเซ็นเตอร์ให้ความสำคัญกับประสิทธิภาพต่อคอร์และความเร็วสัญญาณนาฬิกาเป็นหลัก ตัวอย่างเช่นสถาปัตยกรรม Intel Haswell ซึ่งเน้นการทำงานต่อเธรดที่รวดเร็ว แม้จะมีจำนวนคอร์ไม่มากเท่าซีพียูเซิร์ฟเวอร์ยุคหลัง
เมื่อผู้ให้บริการคลาวด์ขนาดใหญ่เติบโตขึ้น แนวทางการออกแบบก็เปลี่ยนไปสู่การเพิ่มจำนวนคอร์ให้มากที่สุด เพื่อเพิ่มปริมาณงานที่ประมวลผลได้ต่อเซิร์ฟเวอร์หนึ่งเครื่องและทำให้ต้นทุนต่อหน่วยคุ้มค่าขึ้น
ผู้ผลิตซีพียูจึงหันมาใช้สถาปัตยกรรมแบบ Chiplet มากขึ้น โดยแยกส่วนประมวลผลออกเป็นชิปย่อยหลายส่วนแทนการรวมทุกอย่างไว้บน Die เดียว ซึ่งช่วยเพิ่มความยืดหยุ่นในการออกแบบและขยายจำนวนคอร์ได้ แต่การสื่อสารระหว่างชิปย่อยก็อาจมีต้นทุนด้านความหน่วงและการใช้พลังงานเพิ่มเติม
อย่างไรก็ตาม เมื่อ Agentic AI เข้ามามีบทบาทมากขึ้น รูปแบบงานก็เปลี่ยนไปอีกครั้ง เพราะ AI Agent ไม่ได้ส่งงานให้ GPU ประมวลผลเพียงครั้งเดียวแล้วจบ แต่ต้องวนทำงานหลายขั้นตอน เช่น เรียกใช้เครื่องมือ อ่านข้อมูล ประมวลผลคำสั่ง รันโค้ด ตรวจสอบผลลัพธ์ และส่งข้อมูลกลับไปให้โมเดล AI วิเคราะห์ต่อ
ในวงจรการทำงานนี้ ซีพียูต้องจัดการงานที่ไม่สามารถขนานกันได้ทั้งหมดให้เสร็จอย่างรวดเร็ว ก่อนส่งงานกลับไปยัง GPU เพื่อประมวลผลขั้นตอนถัดไป หากซีพียูช้า GPU ก็อาจต้องรอ แม้ตัว GPU จะมีพลังประมวลผลเหลือเฟือก็ตาม
NVIDIA จึงต้องการให้ Vera รวมจุดเด่นสองด้านเข้าด้วยกัน ได้แก่ ประสิทธิภาพต่อคอร์สูงและปริมาณงานรวมที่สูง แทนที่จะเพิ่มจำนวนคอร์เพียงอย่างเดียวเหมือนแนวทางที่ได้รับความนิยมในยุคคลาวด์ก่อนหน้านี้
Vera แรงกว่า Grace 1.5 เท่า และเร็วกว่า x86 สูงสุด 2 เท่าในงาน AI Agent
ข้อมูลจากการสัมภาษณ์ระบุว่า NVIDIA ประเมิน Vera ว่ามีประสิทธิภาพสูงกว่า Grace ประมาณ 1.5 เท่าในภาพรวม ส่วนเมื่อเปรียบเทียบกับซีพียู x86 ชั้นนำในงาน Agentic AI บริษัทอ้างว่าประสิทธิภาพสามารถเพิ่มขึ้นได้สูงสุด 2 เท่า โดยมีผลเฉลี่ยแบบ Geometric Mean อยู่ที่ประมาณ 1.6 เท่า
งานที่ได้รับประโยชน์จากแนวทางนี้ ได้แก่ การรันสคริปต์ Python การคอมไพล์ซอฟต์แวร์ด้วย LLVM และงานอื่น ๆ ที่มีขั้นตอนประมวลผลต่อเนื่อง ซึ่งไม่สามารถเร่งให้เร็วขึ้นได้ด้วยการเพิ่มจำนวนคอร์เพียงอย่างเดียว
Vera ใช้แกนประมวลผล Olympus ที่ NVIDIA ออกแบบเอง พร้อมโครงสร้างภายในที่เน้นเพิ่มปริมาณคำสั่งที่ประมวลผลได้ต่อรอบสัญญาณนาฬิกา หรือ IPC และมีความกว้างในการถอดรหัสคำสั่ง (Decode Width) สูงถึง 10 คำสั่งต่อรอบตามข้อมูลสถาปัตยกรรมที่บริษัทเปิดเผย
อย่างไรก็ตาม ตัวเลขประสิทธิภาพ 1.5 และ 2 เท่าเป็นข้อมูลที่ NVIDIA ระบุ โดยผลลัพธ์จริงยังขึ้นอยู่กับประเภทงาน ซอฟต์แวร์ การตั้งค่าระบบ และซีพียูที่นำมาเปรียบเทียบ จึงไม่ควรตีความว่า Vera จะเร็วกว่าโปรเซสเซอร์ x86 ทุกชนิดสองเท่าในทุกสถานการณ์
Spatial Multithreading แยกทรัพยากร Worker และ I/O ไม่ให้แย่งรอบประมวลผลกัน
อีกจุดเด่นของ Vera คือเทคโนโลยี Spatial Multithreading ซึ่งแตกต่างจากแนวทาง Simultaneous Multithreading (SMT) ที่ Intel และ AMD ใช้ในซีพียูหลายรุ่น
NVIDIA อธิบายว่า Spatial Multithreading ช่วยแบ่งทรัพยากรภายในคอร์ให้กับเธรดสองประเภท ได้แก่ Worker Thread สำหรับงานประมวลผลหลัก และ I/O Thread สำหรับจัดการงานด้านอินพุตเอาต์พุตหรือกิจกรรมเบื้องหลัง
เป้าหมายคือป้องกันไม่ให้งาน I/O เข้ามาแย่งทรัพยากรจากเธรดหลักมากเกินไป โดยเฉพาะในระบบ AI ที่มีงานจำนวนมากเกิดขึ้นพร้อมกันและแต่ละงานมีรูปแบบการใช้ทรัพยากรที่แตกต่างกัน
ในการสัมภาษณ์ NVIDIA ยังกล่าวถึงข้อสงสัยเรื่องความหน่วงจากการแบ่งทรัพยากรและการคาดการณ์ทางแยกคำสั่ง (Branch Prediction) แต่ไม่ได้ให้ตัวเลขจำนวน Cycle ที่แน่นอนสำหรับการฟื้นตัวเมื่อเกิด Branch Misprediction แต่ละกรณี
บริษัทชี้แจงแทนว่า Spatial Multithreading ไม่ได้ทำให้ประสิทธิภาพลดลง แต่กลับช่วยเพิ่มประสิทธิภาพในงานที่เหมาะสม โดยอ้างผลการทดสอบจาก Phoronix ที่พบว่าการเปิดใช้งานฟีเจอร์นี้ช่วยเพิ่มประสิทธิภาพโดยรวมได้ประมาณ 20% ในงานที่ได้รับประโยชน์จากการประมวลผลหลายเธรด
ผลทดสอบอิสระของ Phoronix บนระบบ Vera แบบสองซ็อกเก็ตก็พบประโยชน์จาก Spatial Multithreading ในงานหลายประเภท อย่างไรก็ตาม อัตราการเพิ่มประสิทธิภาพแตกต่างกันตามลักษณะงาน และไม่ได้เพิ่มขึ้น 20% ในทุกการทดสอบ
เลือก Die เดียวแทน Chiplet ดันแบนด์วิดท์ระหว่างคอร์ 3.4TB/s
หนึ่งในการตัดสินใจที่สำคัญที่สุดของ NVIDIA คือการออกแบบ Vera ให้มี Compute Die แบบ Monolithic หรือรวมแกนประมวลผลทั้งหมดไว้บนซิลิคอนชิ้นเดียว แทนการแยกเป็น Chiplet หลายชิ้นเหมือนซีพียูเซิร์ฟเวอร์คู่แข่งบางรุ่น
เหตุผลสำคัญคือการสื่อสารระหว่างคอร์มีผลต่อประสิทธิภาพของงาน AI Agent ซึ่งต้องแลกเปลี่ยนข้อมูลและบริบทระหว่างงานย่อยอยู่ตลอดเวลา การรวมคอร์ไว้บน Die เดียวช่วยลดความจำเป็นในการส่งข้อมูลข้ามขอบเขตของชิปย่อยและลดต้นทุนด้านความหน่วงจากการเชื่อมต่อดังกล่าว
Vera ยังใช้ NVIDIA Scalable Coherent Fabric รุ่นที่ 2 เพื่อให้คอร์และส่วนต่าง ๆ ภายในโปรเซสเซอร์สื่อสารกันได้อย่างมีประสิทธิภาพ โดย NVIDIA ระบุว่าระบบนี้มี Bisection Bandwidth สูงถึง 3.4TB/s หรือประมาณ 3 เท่าของซีพียู x86 ชั้นนำตามเกณฑ์เปรียบเทียบของบริษัท
Bisection Bandwidth เป็นตัวชี้วัดความสามารถในการส่งข้อมูลข้ามส่วนต่าง ๆ ของระบบ ไม่ใช่ความเร็วหน่วยความจำที่ซีพียูอ่านหรือเขียนได้โดยตรง ดังนั้นจึงไม่ควรนำตัวเลข 3.4TB/s ไปเทียบกับแบนด์วิดท์ DRAM แบบตรง ๆ
ในส่วนของหน่วยความจำ Vera ใช้ระบบ LPDDR5X ที่ปรับแต่งมาสำหรับดาต้าเซ็นเตอร์ โดยข้อมูลแพลตฟอร์มที่ NVIDIA เปิดเผยระบุแบนด์วิดท์หน่วยความจำรวมสูงสุดประมาณ 1.2TB/s พร้อมแคช L3 แบบรวมขนาด 164MB ซึ่งช่วยให้แกนประมวลผลเข้าถึงข้อมูลได้สะดวกขึ้น
การผสมผสานระหว่างคอร์ประสิทธิภาพสูง แบนด์วิดท์ระหว่างคอร์ และหน่วยความจำแบนด์วิดท์สูง จึงเป็นแนวทางที่ NVIDIA ใช้ตอบโจทย์งานซึ่งต้องสลับการทำงานระหว่าง CPU และ GPU อย่างต่อเนื่อง
อย่างไรก็ตาม NVIDIA ไม่ได้ปฏิเสธเทคโนโลยี Chiplet อย่างถาวร โดยระบุว่าการเลือกใช้ Die เดียวหรือหลายชิปขึ้นอยู่กับเป้าหมายด้านประสิทธิภาพและลักษณะตลาด หากในอนาคตมีความจำเป็น บริษัทก็พร้อมพิจารณาสถาปัตยกรรมแบบ Chiplet เช่นกัน
NVIDIA เตรียมขาย Vera แยกเป็นแร็ก CPU ไม่ได้มีหน้าที่แค่ป้อนข้อมูลให้ GPU
เดิมที Grace ถูกวางตำแหน่งให้เป็นซีพียู Host สำหรับจัดการข้อมูลและป้อนงานให้ GPU ภายในระบบ AI ของ NVIDIA แต่บริษัทระบุว่าความต้องการจาก Agentic AI และ Reinforcement Learning ทำให้เกิดรูปแบบการใช้งานใหม่ที่ต้องการซีพียูจำนวนมากโดยไม่จำเป็นต้องติดตั้ง GPU จำนวนมากตามไปด้วย
ระบบ AI Agent ต้องเรียกใช้เครื่องมือจำนวนมาก เช่น รันโปรแกรม ค้นหาข้อมูล ประมวลผลโค้ด และทดสอบคำตอบ ซึ่งกิจกรรมเหล่านี้อาจใช้ CPU เป็นหลัก แม้จะเชื่อมโยงกับกระบวนการทำงานของโมเดล AI ที่ใช้ GPU ก็ตาม
NVIDIA เปิดเผยว่าผู้ให้บริการ Sandbox บางรายมีสภาพแวดล้อม Sandbox สำหรับลูกค้ารายเดียวสูงถึง 400,000 ชุด และอุตสาหกรรมกำลังมุ่งไปสู่ระบบที่ต้องรองรับงานลักษณะนี้ในระดับใหญ่มาก
Sandbox คือสภาพแวดล้อมแยกสำหรับรันโค้ดหรือโปรแกรมอย่างเป็นอิสระจากระบบหลัก เมื่อ AI Agent ต้องเรียกใช้เครื่องมือหรือทดสอบคำสั่งหลายครั้ง ก็อาจต้องสร้างและจัดการสภาพแวดล้อมเหล่านี้จำนวนมาก จึงเพิ่มความต้องการด้าน CPU หน่วยความจำ และระบบจัดการงานพร้อมกัน
เมื่อถูกถามถึงแนวคิดที่ว่าอัตราส่วน CPU ต่อ GPU อาจเพิ่มขึ้นถึง 80 ต่อ 1 ตามกระแสข่าวเกี่ยวกับ AI Agent บางราย NVIDIA ระบุว่าไม่มีตัวเลขคาดการณ์อย่างเป็นทางการ และไม่ต้องการยืนยันอัตราส่วนดังกล่าว เพราะความต้องการของแต่ละระบบแตกต่างกัน
สิ่งที่บริษัทมั่นใจคือความต้องการซีพียูมีแนวโน้มเพิ่มขึ้น และนี่เป็นเหตุผลที่ Vera ไม่ได้ถูกวางไว้เฉพาะในระบบ Vera-Rubin ที่รวม CPU และ GPU เข้าด้วยกัน แต่ยังเตรียมทำตลาดเป็นซีพียูแบบ Standalone สำหรับติดตั้งเป็นแร็กที่มีเฉพาะ CPU เพื่อรองรับงาน Agent Tool Calls และ Reinforcement Learning ด้วย
Vera คือการเดิมพันกับยุคที่ AI ต้องใช้ CPU และ GPU ทำงานร่วมกัน
การพัฒนา Vera สะท้อนให้เห็นว่าการแข่งขันด้าน AI ไม่ได้อยู่ที่ GPU เพียงอย่างเดียวอีกต่อไป เมื่อระบบ AI Agent ต้องทำงานแบบวนซ้ำและมีหลายขั้นตอน ความเร็วของ CPU การจัดการเธรด และการสื่อสารระหว่างแกนประมวลผลก็เริ่มมีความสำคัญมากขึ้น
NVIDIA จึงออกแบบ Vera ให้เน้นประสิทธิภาพต่อคอร์ การเข้าถึงข้อมูล และความหน่วงต่ำ ขณะเดียวกันก็รองรับการทำงานหลายเธรดและการติดตั้งเป็นระบบขนาดใหญ่ได้
อย่างไรก็ตาม ยังต้องพิจารณาผลทดสอบจริงในงานแต่ละประเภท ต้นทุนของแพลตฟอร์ม และประสิทธิภาพต่อพลังงานเมื่อเทียบกับซีพียูคู่แข่ง ก่อนสรุปว่าแนวทางนี้จะเปลี่ยนตลาดเซิร์ฟเวอร์ได้มากเพียงใด
สิ่งที่ชัดเจนคือ NVIDIA ต้องการให้ Vera เป็นมากกว่าซีพียูที่คอยป้อนข้อมูลให้ GPU แต่เป็นหน่วยประมวลผลหลักสำหรับจัดการงานเบื้องหลังของ AI Agent ซึ่งมีแนวโน้มจะกลายเป็นองค์ประกอบสำคัญของดาต้าเซ็นเตอร์ในยุคถัดไป
ที่มา: Wccftech